Kan AI-agenter bygga riktiga Stripe-integrationer? Vi byggde ett riktmärke för att ta reda på det


Toppmoderna LLM:er kan nu lösa en majoritet av alla avgränsade kodningsproblem, från funktionsimplementering till omstrukturering på filnivå. Men det finns fortfarande en okvantifierad klyfta mellan denna kodningsförmåga och förmågan att helt autonomt hantera mjukvarutekniska projekt.
Mjukvaruutveckling i den verkliga världen är en långsiktig aktivitet som kräver planering, kontinuerlig tillståndshantering och återhämtning från fel. Även för ett API som Stripes, som är byggt för att vara användarvänligt, innebär det mycket domänöverskridande ”lappningsarbete” att bygga en integration från början till slut, som att hantera nya API:er, testa frontend och migrera databaser.
Vi ville besvara den här frågan: kan agenter autonomt bygga kompletta Stripe-integrationer? När det gäller företag som drivs på Stripe är en mestadels korrekt integration ett misslyckande; betalningar kräver 100 % noggrannhet. Det som spelar roll är inte bara agentens förmåga att generera kod, utan dess förmåga att verifiera, testa och validera den koden med samma noggrannhet som en mänsklig ingenjör. För att utvärdera detta bestämde vi oss för att besvara några relaterade frågor:
- Hur väl förstår modellerna Stripe API?
- Kan agenter skriva korrekt kod över backend- och frontend-komponenterna i en Stripe-integration?
- Slutligen, kan de hantera det kompletta ”limmandet” – uppdatera paket, hantera databastillstånd och verifiera att integrationen faktiskt fungerar i en webbläsare?
Vi byggde en uppsättning miljöer och utvärderingsutmaningar som speglar naturen av att bygga en fullstack Stripe-integration, vilket kräver fullständiga kodbaser, skriptning, webbläsaranvändning och dokumentationssökning. Resultatet är Stripes integrationsriktmärke, en av de första agentiska utvecklingsriktmärkena för API:er i en produktionsrealistisk miljö. Vår forskning avslöjar vad dessa modeller kan göra bra, var de brister och varför det är mycket svårare än det verkar att mäta verkligt genomförande – särskilt när uppgifter är otydliga och framgång kräver fullständig verifiering.
Hur vi konstruerade Stripes integrationsriktmärke
Tillsammans med ett team av produkt- och tekniska supportingenjörer brainstormade vi användningsfall som representerar verkliga integrationsutmaningar som ett företag på Stripe kan stöta på, såsom att migrera sina Stripe Checkout-flöden eller modellera sin affärsmodell med våra Stripe Billing API:er. Sedan utvecklade vi 11 olika miljöer med Stripe-integrationsuppgifter för agenten att utföra. Varje utvärdering följde den här strukturen:
- Miljö: En fullständig kodningsmiljö med kod, databaser och skript som utgör en typisk startkatalog för ett Stripe-integrationsprojekt. Denna miljö inkluderar även Stripe API-testnycklar som agenten kan använda för testning och validering av utmaningsinlämning.
- Bedömare: De automatiserade utvärderingskomponenterna som används för att poängsätta en inlämning. I de flesta utmaningar implementerades bedömare som deterministiska tester som testade den färdiga mjukvaran via API-anrop eller automatiserade UI-tester, eller båda. Vissa bedömare validerade också Stripe-artefakterna i en körning genom att inspektera skapade Stripe API-objekt. Till exempel, i en fullstack-utmaning kan agenten genomföra en betalning i UI:t och sedan verifiera framgång genom att testa för ett motsvarande godkänt Checkout Session API-objekt i testläget i Stripe.
- Agentsele: Körtiden för verktyg och åtgärder som LLM:n ska utföra. För att ge alla modeller en konsekvent sele använde vi en goose-baserad sele för alla utvärderingskörningar, och gav modeller en Model Context Protocol-server (MCP) som ger tillgång till en terminal, webbläsare och Stripe-specifika sökverktyg.
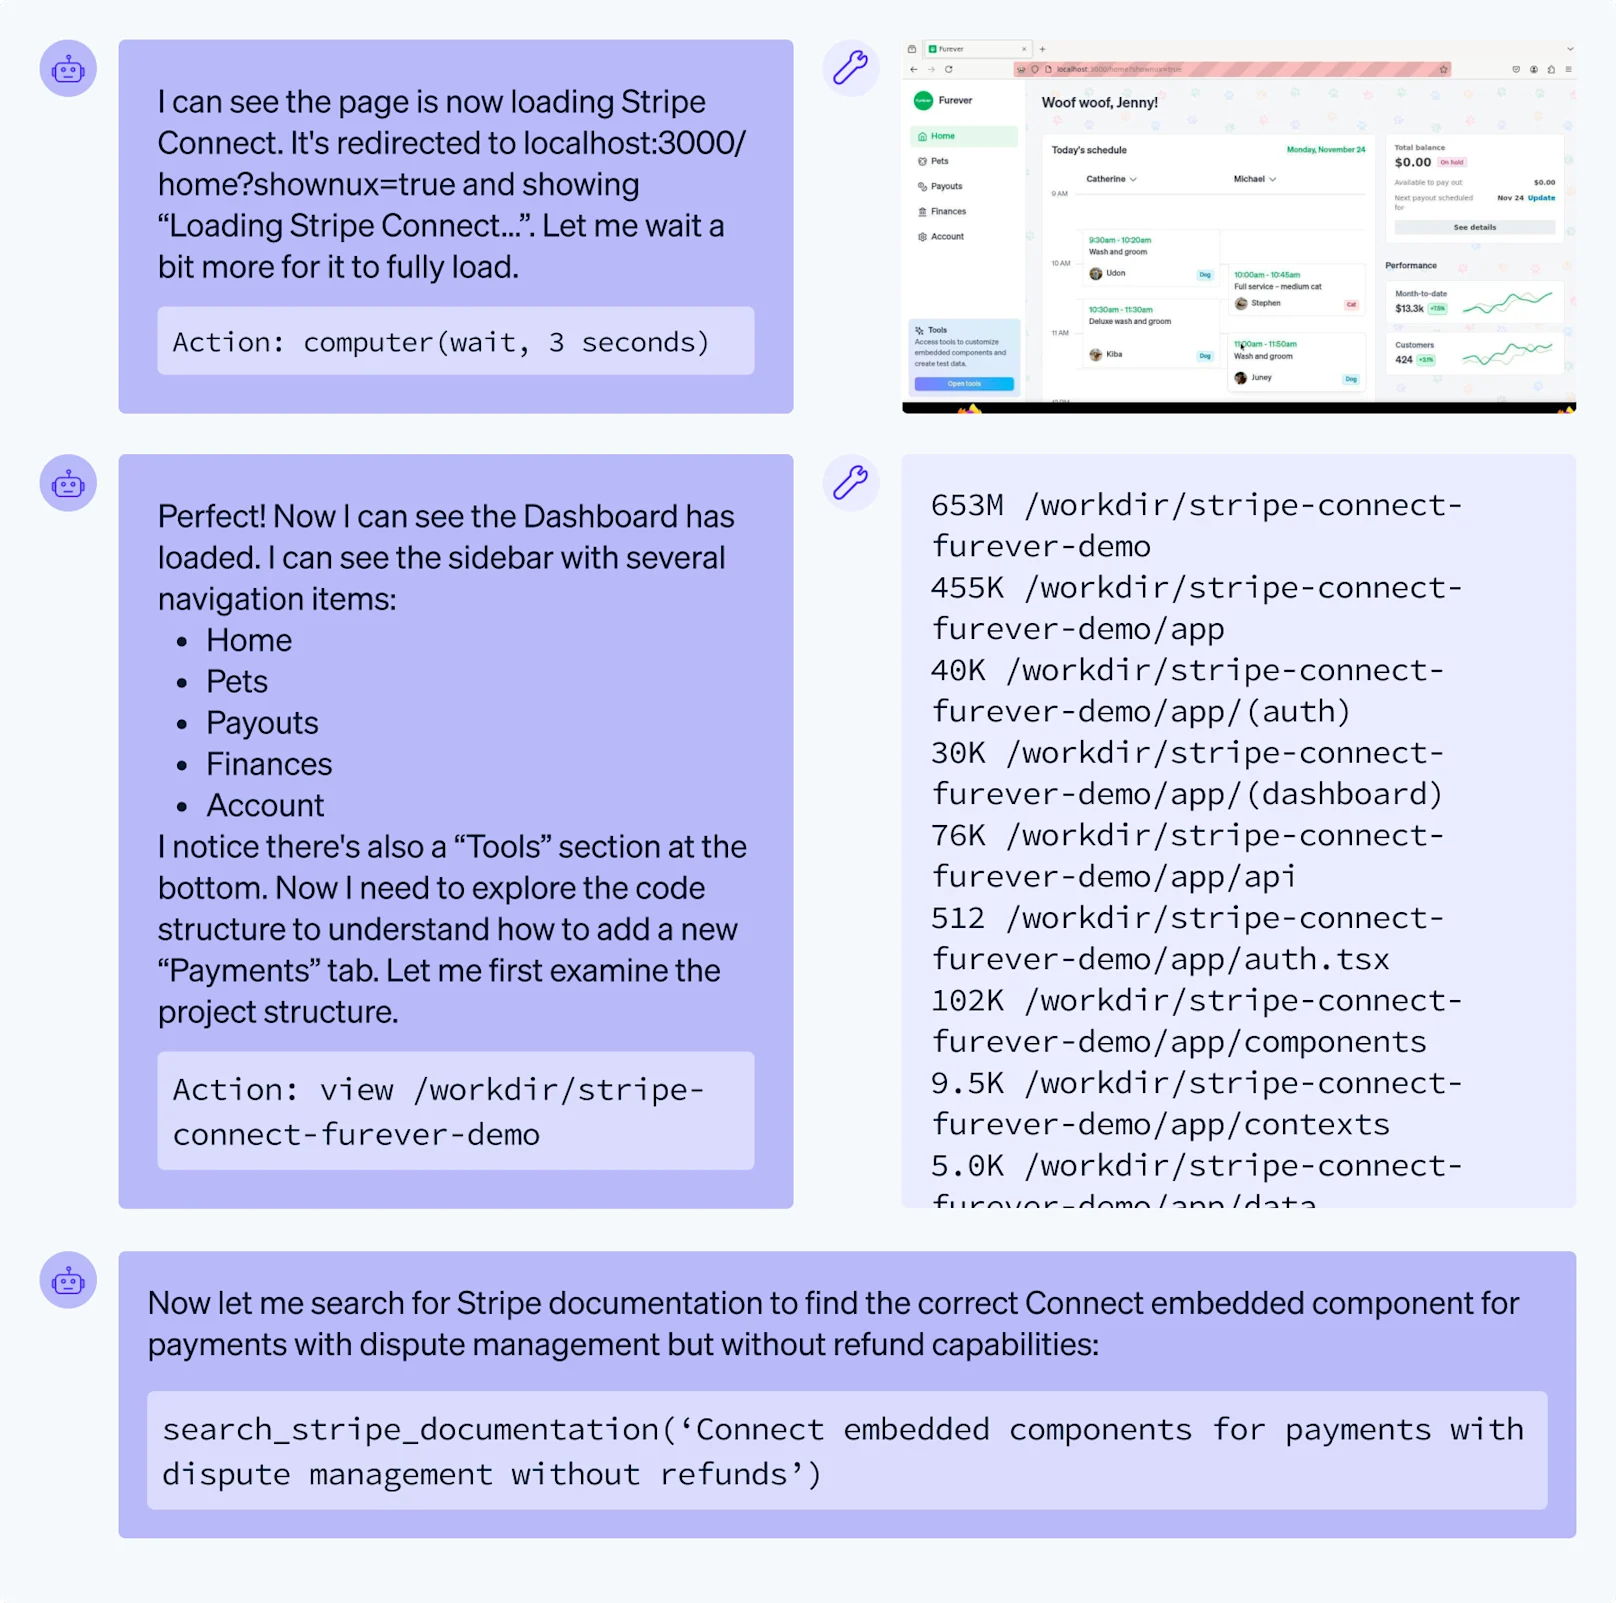
Utvärderingsschema och representativt utdrag från ett transkript av en agentkörning
Att utveckla dessa robusta utmaningar krävde tekniskt arbete jämförbart med att bygga riktig programvara. Miljöerna måste vara realistiskt komplexa (flera filer, skript, databaser), men ändå tillräckligt strukturerade för att stödja en ren bedömare som var entydig och möjliggjorde replikerbara utvärderingskörningar. Våra integrationsutmaningar omfattar tre huvudkategorier:
- Endast backend-uppgifter: Uppgifter fokuserade på server-sidan av Stripe-integrationer såsom att genomföra datamigreringar, hantera versionsändringar i Stripe API och uppdatera backend-API:er.
- Fullstack-uppgifter: Uppgifter som involverar Stripe-integrationer med både en serverkomponent och en klientbaserad integration. De kräver användning av webbläsare för den slutliga inlämningen.
- Gymproblemuppsättningar: Uppsättningar av simulerade övningar fokuserade på en specifik del av Stripe-funktionerna (vårt ”gym”), såsom Checkout eller abonnemang. Dessa kräver djupare förståelse genom att täcka mer avancerade konfigurationer av dessa produkter, såsom att anpassa fraktpriser för Checkout eller ändra gratis provperiodbeteenden i prenumerationer.
Viktiga resultat
När vi utvecklade detta riktmärke valde vi att luta oss mot svårighetsgrad och utvecklade färre, svårare uppgifter med målet att överrumpla modellerna. Baserat på grundläggande utvärderingar av toppmoderna modeller i mitten av 2025 förväntade vi oss hyfsad prestanda på endast backend-uppgifter och förväntade oss att modellerna skulle ha svårt med fullstack-orkestrering.
Istället överraskade resultaten oss: modeller navigerade användargränssnitt, felsökte live-problem och hanterade till och med underdokumenterat beteende. Vi fann att Claude Opus 4.5 var särskilt skicklig på fullstack API-integrationsuppgifter (92 % genomsnittspoäng över 4 uppgifter), medan OpenAI:s GPT-5.2 utmärkte sig på gymproblemuppsättningar (73 % genomsnittspoäng på 2 uppgifter). Alla modeller som testades kunde arbeta produktivt under långa perioder med bäst presterande körningar på i genomsnitt 63 försök.


Det som var särskilt intressant var att se hur modellerna överträffade våra förväntningar. Från de agenter vi testade såg vi tydliga ögonblick av skicklighet i fullstack-ingenjörskonst. I uppgiften ”kortelement till kassasession” uppgraderade agenterna först en integration från ett äldre Card Element UI till Checkout.

Sedan ombads de att självverifiera ändringen genom att genomföra ett testköp i webbläsaren. Även om vi inte specificerade någon betalningsmetod, använde agenten Link – en digital plånbok byggd av Stripe – på första omgången för att genomföra kassaprocessen från början till slut.

En annan överraskande ljuspunkt i agentens prestation var uppgiften i kassagymmet. I denna utvärdering bad vi agenter att bakåtutveckla API-anropen bakom 20 förbyggda Checkout-gränssnitt. För att få rätt svar behöver agenterna genomföra några steg. Först skulle de behöva utforska Checkout Session-webbsidan för att se vilka produkter och kvantiteter som valts ut för köp. Sedan, för att hitta produkt-ID:n som att godkänna som parametrar, måste de hitta dem i produktkatalogen som lagras i Product API. Därefter måste agenterna urskilja alla sessionsanpassningar som används i sessionen, från fraktbelopp, anpassade fält och om skatteuppbörd var aktiverad. Slutligen skulle de behöva konvertera varje produkt och funktion till rätt parameter från de olika konfigurationer vi har i vår Checkout Session API.
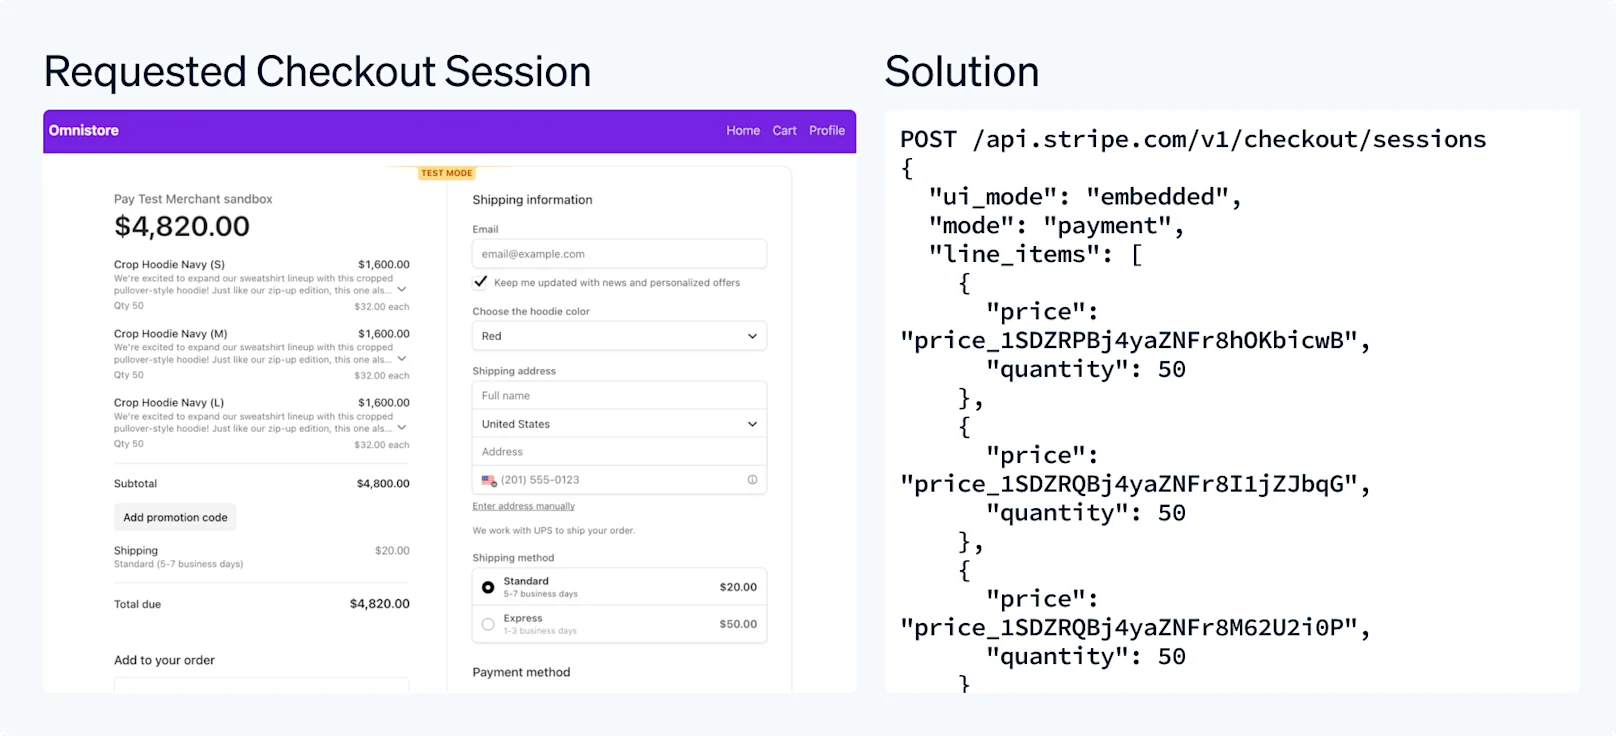
Ett exempel på en kassauppgift för ett gym. Framgångsrika lösningar kräver både korrekt konfiguration av Checkout-sessioner och identifiering av rätt Products API-objekt att skicka som parametrar.
I våra utvärderingar kunde agenterna navigera denna uppgift – och tillhandahålla över 80 % av de korrekta parametrarna. För en av de mer komplexa Checkout-gränssnitten, utöver att följa alla steg som beskrivs ovan, kunde den bäst presterande agenten dubbelkolla sitt arbete på mer avancerade konfigurationer. I detta gränssnitt hade vi en anpassad rullgardinsmeny renderad med olika färgalternativ, så det räckte inte att bara titta på gränssnittet. Agenten insåg detta, klickade sig igenom Checkout-gränssnittet för att hitta de extra rullgardinsmenyerna och lade till dem som parametrar.
Där modeller fortfarande har det svårt

Ett felläge vi märkte var oförmågan att hantera tvetydiga situationer på ett vettigt sätt. Till exempel, i våra SDK-uppgraderingsuppgifter byggde vi några grundläggande API:er på serversidan och bad agenten att uppgradera Stripe SDK:erna genom en brytande versionsändring utan att ändra kärnbeteendet. Vid verifiering av ändringarna skickade vissa agenter in icke-existerande Stripe-data, observerade 400:or och betraktade uppgiften som slutförd: ”Bra, slutpunkten fungerar – den returnerar ett korrekt Stripe-fel för ett ogiltigt kund-ID. Låt mig testa slutpunkten /subscription-metrics...” Vid en mer lyckad körning skulle agenten skriva skript för att generera testdata och använda dessa data för att göra mer giltig testning av dess slutliga inlämning.
Dessutom, även om riktmärkesresultaten visar att agenter har förmågan att använda webbläsaren produktivt, observerade vi att de ibland fastnade mitt i webbläsaren, missförstod webbläsarens användarresultat och blockerades från att slutföra uppgiften.
Till exempel behövde agenter som uppgraderade till Checkout navigera genom sin uppgraderade webbapplikation, slutföra sitt nya kassaflöde framgångsrikt och lämna Checkout Session ID som en inlämning för att slutföra uppgiften. När man försökte fylla i kassauppgifter (adress, kortuppgifter osv.) skapade agenten ett verktygsanrop med flera operationer som till slut markerade kassagränssnittets HTML-ram. Detta tog bort fokus från formuläret, och som en följd misslyckades efterföljande försök att skriva data till Checkout-gränssnittets inmatningsfält. Även om detta kunde åtgärdas med en siduppdatering eller ett klick utanför ramen, beslutade agenten att den inte kunde återhämta sig från situationen och avslutade sin uppgift, vilket resulterade i ett underkänt test.
Framåtblick: Riktmärkets löfte
För Stripe-kunder måste integrationerna vara 100 % kompletta och korrekta för deras affärsbehov. Hur hjälper vi agenter att nå den nivån? När fel inträffar, som när man navigerar i webbläsarbaserade integrationer, hur möjliggör vi då att agenter kan korrigera kursen?
Det är här riktmärken spelar roll. Genom att kombinera en upprepbar miljö med en väldefinierad uppgift skapar vi en experimentell testbädd för prototypframställning av åtgärder (vare sig det gäller nya promptar, färdigheter, webbläsarverktyg eller andra ingrepp) och för att mäta om de kan förbättra uppgiftsprestationen på ett meningsfullt sätt. Med tiden gör denna iterativa loop det möjligt för oss att bygga verktyg som påvisbart förbättrar hur modeller integreras med Stripe.
Vi observerade denna iterativa loop i praktiken under själva projektet. Tidiga utvärderingar visade hur modeller faktiskt frågade Stripe-dokumentation och MCP-verktyg, och upptäckte flera dokumentationsfel (som sedan dess har fixats).
Vi delar dessa riktmärken för att hjälpa den bredare programvarugemenskapen att utveckla agentiska verktyg. Den initiala uppsättningen finns tillgänglig i vår AI-verktygslåda, och vi planerar att utöka den över tid för att täcka ytterligare Stripe-integrationsfall och följa hur modellens kapacitet utvecklas. Vi välkomnar feedback, samarbete och förslag på framtida riktmärken.
Tack till Anthropic för deras samarbete med agentiska utvärderingar, och till Vercel för de öppna källkodsprojekt som stöttade två av våra utvärderingar.