Können KI-Agenten echte Stripe-Integrationen entwickeln? Wir haben eine Benchmark entwickelt, um das herauszufinden


Mit hochmodernen LLMs lässt sich jetzt ein Großteil der bereichsbezogenen Codierungsprobleme lösen, von der Funktionsimplementierung bis zur Nachbearbeitung auf Dateiebene. Zwischen dieser Codierungsfunktion und der Fähigkeit, Software-Engineering-Projekte vollständig autonom zu verwalten, besteht jedoch noch eine bislang nicht quantitativ erfasste Kluft.
Software-Engineering ist in der Praxis eine Tätigkeit mit langem zeitlichem Horizont, die Planung, dauerhafte Statusverwaltung und Wiederherstellung nach Fehlern erfordert. Selbst für eine API wie die von Stripe, die auf Benutzerfreundlichkeit ausgelegt ist, ist die End-to-End-Bereitstellung einer Integration mit viel domänenübergreifendem Aufwand verbunden – von der Handhabung neuer APIs und dem Testen von Frontends bis zur Migration von Datenbanken.
Wir wollten diese Frage beantworten: Können Agenten selbstständig komplette Stripe-Integrationen erstellen? Wenn es um Unternehmen geht, die Stripe nutzen, kommt eine weitgehend korrekte Integration einem Scheitern gleich, da Zahlungen hundertprozentige Präzision erfordern. Wichtig ist nicht nur die Fähigkeit eines Agenten, Code zu generieren, sondern auch seine Fähigkeit, diesen Code mit der Rigorosität eines menschlichen Entwicklers/einer menschlichen Entwicklerin zu verifizieren, zu testen und zu validieren. Um dies zu bewerten, beantworten wir im Folgenden einige damit verbundene Fragen:
- Wie gut verstehen Modelle die Stripe-API?
- Können Agenten korrekten Code für die Backend- und Frontend-Komponenten einer Stripe-Integration schreiben?
- Können sie schließlich auch die kleinteilige End-to-End-Arbeit leisten, indem sie Pakete aktualisieren, den Datenbankstatus verwalten und überprüfen, ob die Integration tatsächlich in einem Browser funktioniert?
Wir haben eine Reihe von Umgebungen und Evaluierungsherausforderungen entwickelt, die die Art der Entwicklung einer Full-Stack-Stripe-Integration widerspiegeln und vollständige Codebases, Scripting, Browsernutzung und das Durchsuchen von Dokumentation erfordern. Das Ergebnis ist die Benchmark für Stripe-Integrationen, eine der ersten Benchmarks für die agentenbasierte Entwicklung von APIs in einer produktionsrealistischen Umgebung. Unsere Forschung zeigt, was diese Modelle gut können, wo sie Mängel aufweisen und warum die Bewertung der Ausführung in der Praxis viel schwieriger ist, als es scheint, insbesondere wenn Aufgaben mehrdeutig sind und der Erfolg End-to-End-Verifizierungen erfordert.
So haben wir die Benchmark für Stripe-Integrationen entwickelt
Mit einem Team von Entwicklerinnen und Entwicklern aus den Bereichen Produktion und technischer Support haben wir ein Brainstorming zu Use Cases durchgeführt, die reale Integrationsherausforderungen darstellen, mit denen ein Unternehmen, das Stripe nutzt, konfrontiert sein kann, wie z. B. die Migration seiner Stripe Checkout-Abläufe oder die Modellierung seines Geschäftsmodells mit unseren Stripe Billing-APIs. Anschließend haben wir 11 verschiedene Umgebungen mit Stripe-Integrationsaufgaben entwickelt, die der Agent erledigen muss. Jede Bewertung folgte der folgenden Struktur:
- Umgebung: Eine vollständige Modellierungsumgebung mit Code, Datenbanken und Scripts, die ein typisches Ausgangs-Repository für ein Stripe-Integrationsprojekt darstellen. Diese Umgebung umfasst auch Test-API-Schlüssel von Stripe, die der Agent für Tests und Herausforderungen bei der Validierung von Einreichungen verwenden kann.
- Grader: Die automatisierten Evaluationskomponenten, die zur Bewertung einer Einreichung verwendet wurden. Bei den meisten Herausforderungen wurden Grader als deterministische Tests implementiert, die die Ausführung der fertigen Software über API-Aufrufe, automatisierte Nutzeroberflächentests oder beides prüften. Einige Grader validierten auch die Stripe-Artefakte einer Ausführung, indem sie erstellte Stripe-API-Objekte überprüften. Bei einer Full-Stack-Herausforderung kann der Agent beispielsweise eine Zahlung auf der Nutzeroberfläche abschließen und dann den Erfolg verifizieren, indem er auf ein entsprechendes erfolgreiches Checkout-Session-API-Objekt im Test-Modus in Stripe testete.
- Agentennutzung: Die Laufzeit der Tools und Aktionen, die das LLM ausführen soll. Um allen Modellen eine konsistente Nutzung zu verleihen, haben wir eine auf Goose basierende Nutzung für alle Bewertungsläufe verwendet und Modelle mit einem Model Context Protocol-Server (MCP-Server) ausgestattet, der Zugriff auf ein Datenterminal, einen Browser und Stripe-spezifische Suchtools gewährt.
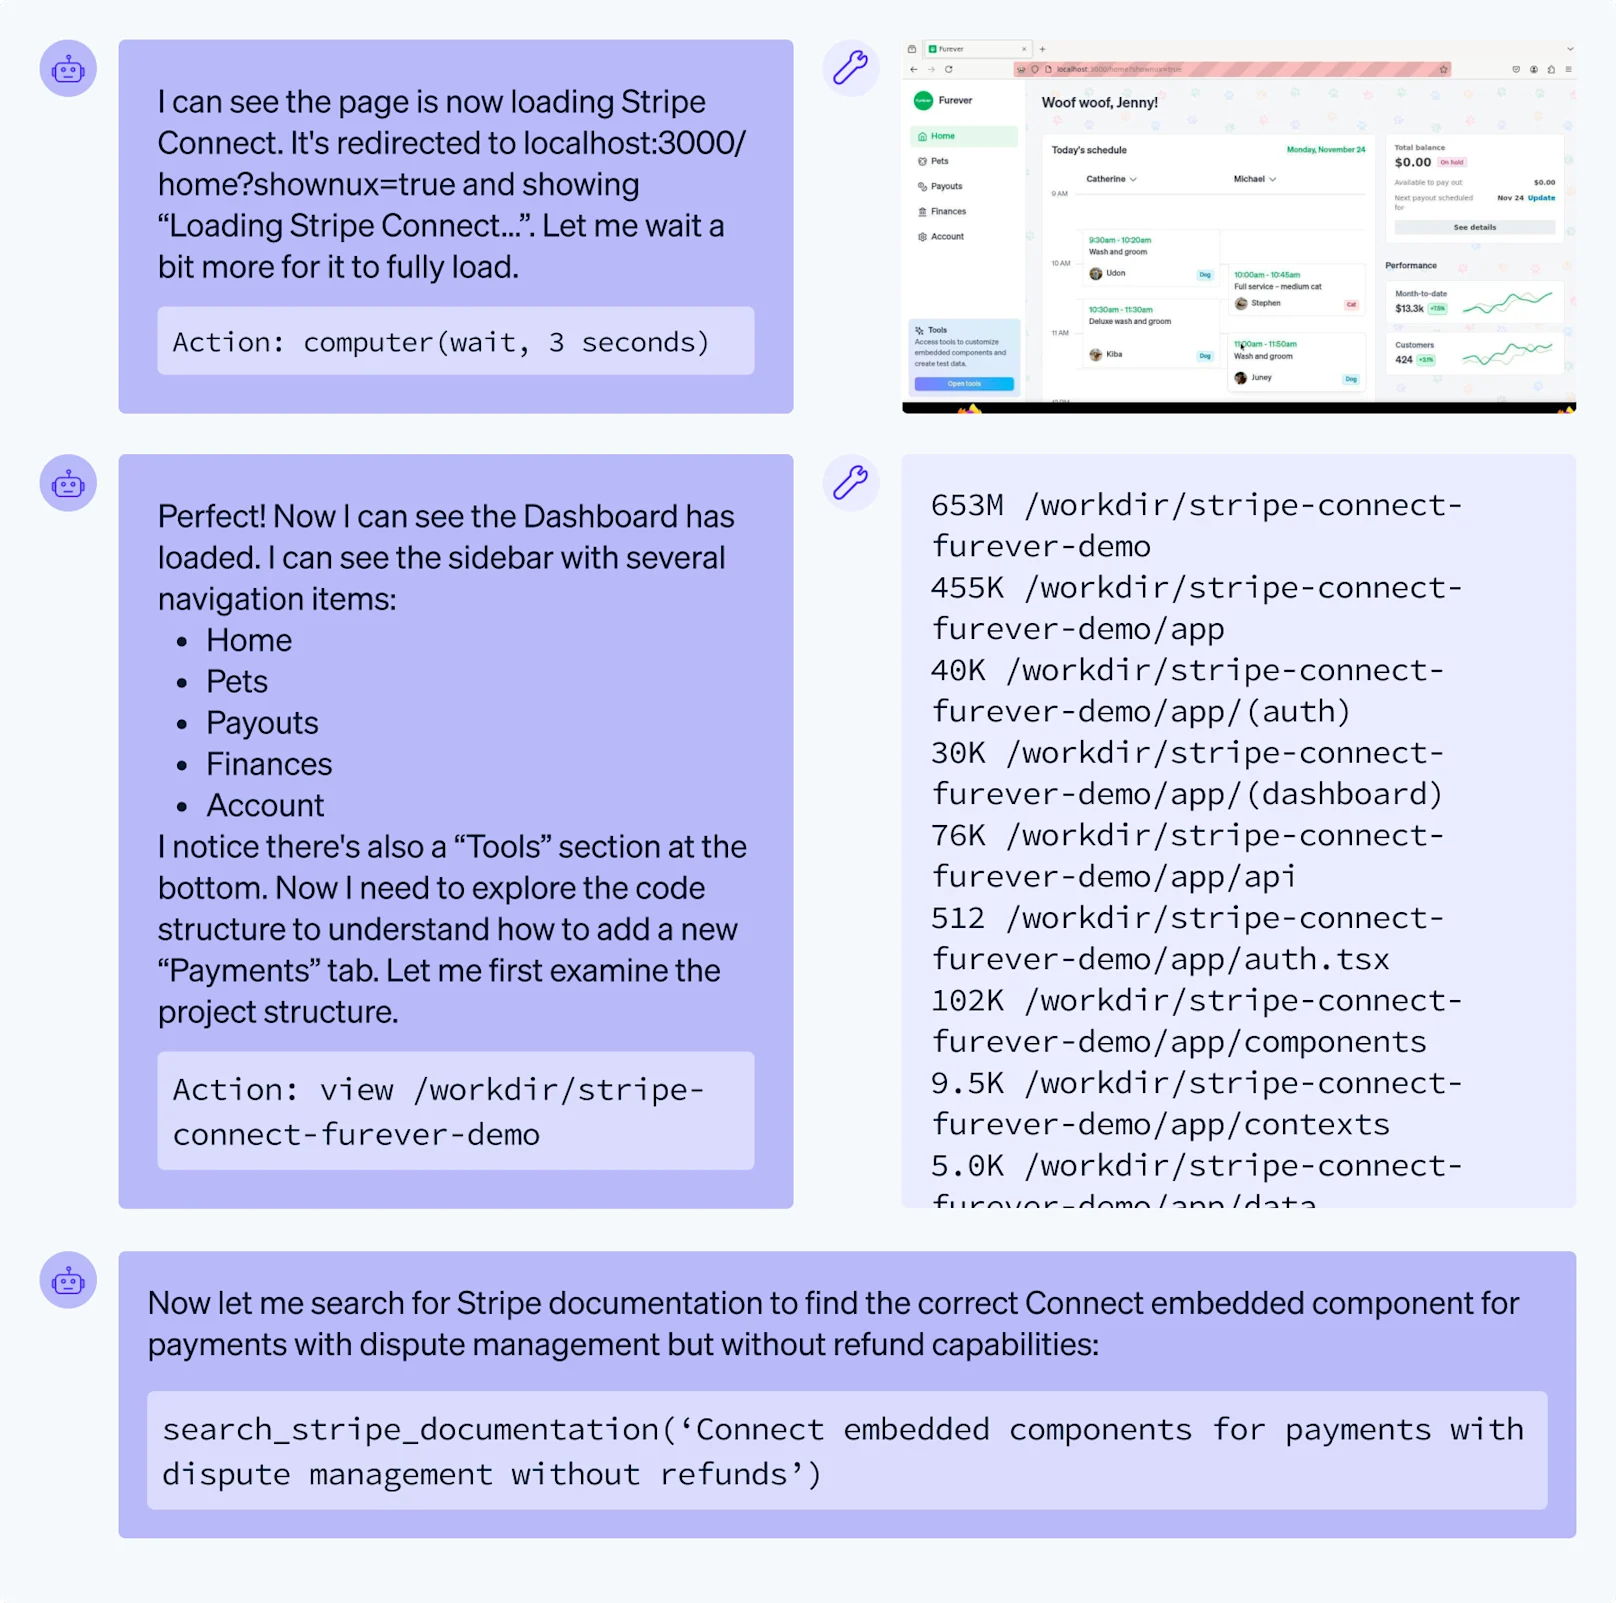
Schematisches und repräsentatives Snippet aus dem Transkript einer Agentenausführung
Die Entwicklung dieser robusten Herausforderungen erforderte technische Arbeit, die mit der Entwicklung realer Software vergleichbar war. Die Umgebungen mussten der Realität entsprechend komplex sein (mehrere Dateien, Scripts, Datenbanken), aber strukturiert genug, um einen sauberen Grader zu unterstützen, der eindeutig war und replizierbare Bewertungsläufe ermöglichte. Unsere Integrationsherausforderungen erstreckten sich auf drei Hauptkategorien:
- Backend-beschränkte Aufgaben: Aufgaben, die sich auf serverseitige Stripe-Integrationsaufgaben konzentrierten, wie z. B. Datenmigrationen abschließen, Versionsänderungen der Stripe-API verarbeiten und Backend-APIs aktualisieren.
- Full-Stack-Aufgaben: Aufgaben, die Stripe-Integrationen sowohl mit einer serverseitigen Komponente als auch mit einer clientseitigen Integration umfassten. Sie erfordern eine Browsernutzung für die endgültige Einreichung.
- Gym-Problem-Sets: Sets simulierter Übungen, deren Schwerpunkt auf einem bestimmten Teil der Funktionen von Stripe liegt (unsere „gym“), etwa Checkout oder Abonnements. Damit streben wir ein tieferes Verständnis an, indem wir fortgeschrittenere Konfigurationen dieser Produkte abdecken, wie z. B. die Anpassung der Versandraten für Checkout oder die Änderung des Verhaltens bei kostenlosen Testversionen in Abonnements.
Zentrale Erkenntnisse
Bei der Entwicklung dieser Benchmark entschieden wir uns für eine größere Bedeutung der Schwierigkeit und entwickelten weniger, schwierigere Aufgaben mit dem Ziel, die Modelle wirklich herauszufordern. Auf der Grundlage rudimentärer Bewertungen hochmoderner Modelle Mitte 2025 erwarteten wir eine ordentliche Performance bei Backend-beschränkten Aufgaben und rechneten damit, dass die Modelle mit Full-Stack-Schwierigkeiten zu kämpfen haben würden.
Stattdessen überraschten uns die Ergebnisse: Die Modelle navigierten Nutzeroberflächen, debuggten Live-Probleme und bekamen selbst unterdokumentiertes Verhalten in den Griff. Wir fanden heraus, dass Claude Opus 4.5 besonders gut mit Full-Stack-API-Integrationsaufgaben umgehen konnte (durchschnittliche Bewertung von 92 % über 4 Aufgaben hinweg), während GPT-5.2 von OpenAI bei „Gym“-Problem-Sets hervorragende Leistungen erzielte (durchschnittliche Bewertung von 73 % über 2 Aufgaben hinweg). Alle gemessenen Modelle konnten über lange Zeiträume produktiv arbeiten, wobei die leistungsstärksten Ausführungen durchschnittlich 63 Durchläufe erreichten.


Besonders interessant war zu sehen, wie die Modelle unsere Erwartungen übertroffen haben. Von den von uns getesteten Agenten konnten wir eine besondere Kompetenz im Full-Stack-Engineering feststellen. Bei der Aufgabe „Card Element für Checkout-Sitzung“ haben die Agenten zunächst eine Integration von einer älteren Nutzeroberfläche des Card Element zu Checkout aktualisiert.

Dann wurden sie aufgefordert, die Änderung selbst zu verifizieren, indem sie einen Testkauf im Browser abschlossen. Obwohl wir keine Zahlungsmethode angegeben haben, hat der Agent in einer Ausführung erfolgreich Link, ein von Stripe entwickeltes Digital Wallet verwendet, um den Bezahlvorgang vollständig abzuschließen.

Ein weiterer überraschender Lichtblick hinsichtlich der Performance der Agenten war die Gym-Aufgabe zum Bezahlvorgang. Bei dieser Bewertung forderten wir die Agenten auf, die API-Aufrufe hinter 20 vorgefertigten Checkout-Nutzeroberflächen rückgängig zu machen. Um die richtige Antwort zu erhalten, mussten die Agenten einige Schritte ausführen. Zunächst mussten sie die Webseite der Checkout-Sitzung durchgehen, um zu sehen, welche Produkte und Mengen für den Kauf ausgewählt wurden. Um dann die Produkt-IDs zu finden, die als Parameter übergeben werden sollten, mussten sie sie im in der Products API gespeicherten Produktkatalog finden. Als Nächstes mussten die Agenten alle in der Sitzung verwendeten Sitzungsanpassungen anhand der Versandbeträge, der nutzerdefinierten Felder und der Frage, ob die Steuererhebung aktiviert wurde, unterscheiden. Schließlich mussten sie jedes Produkt und jede Funktion aus den verschiedenen Konfigurationen, die wir in unserer Checkout Session API haben, in den richtigen Parameter konvertieren.
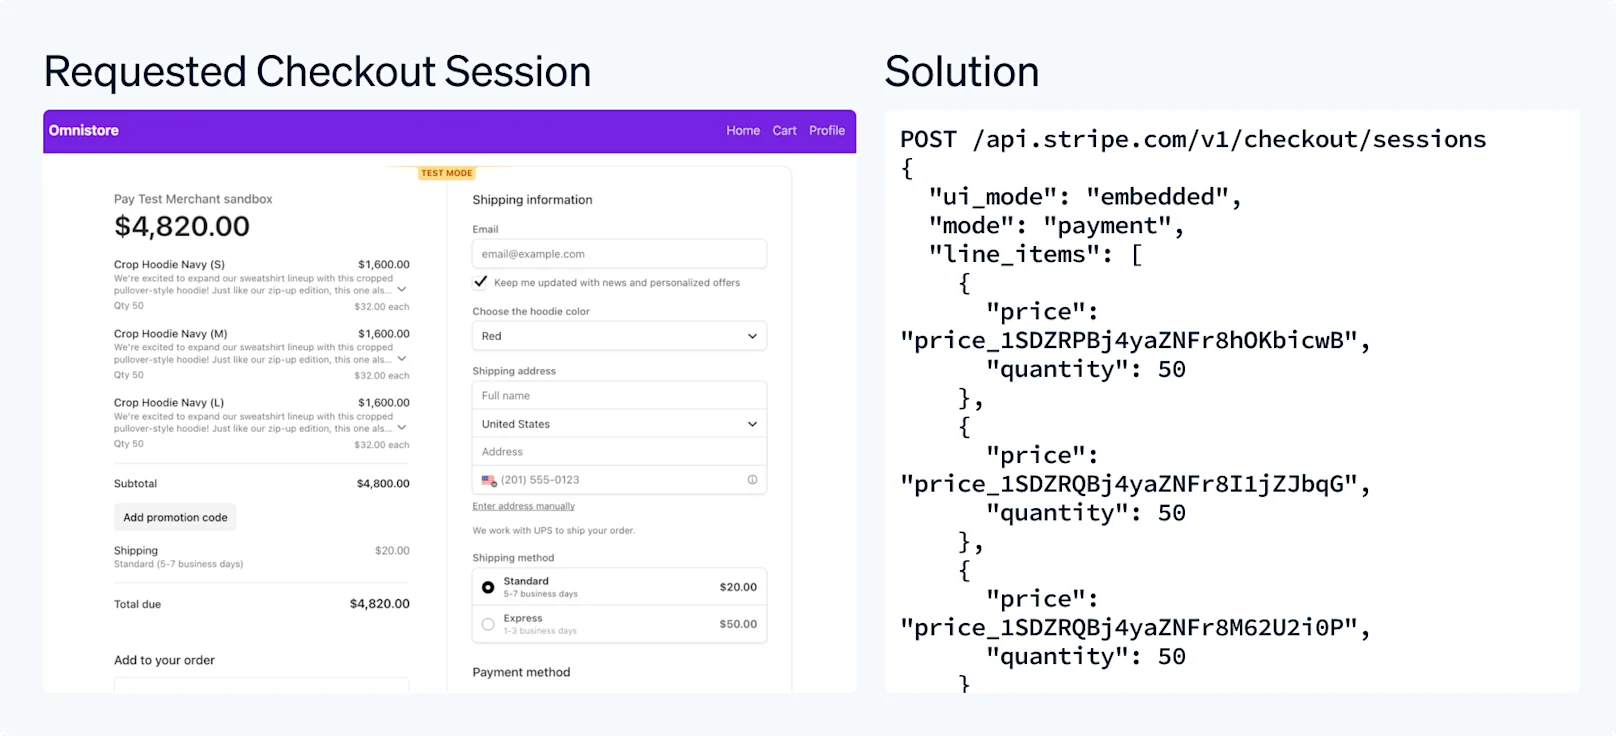
Eine beispielhafte Gym-Aufgabe zum Bezahlvorgang. Erfolgreiche Lösungen erfordern sowohl die korrekte Konfiguration der Checkout-Sitzung als auch die Identifizierung des richtigen Products-API-Objekts zur Übergabe als Parameter.
In unseren Bewertungen konnten die Agenten diese Aufgabe navigieren und über 80 % der korrekten Parameter bereitstellen. Für eine der komplexeren Checkout-Nutzeroberflächen konnte der leistungsfähigste Agent zusätzlich zu allen oben beschriebenen Schritten seine Arbeit an erweiterten Konfigurationen überprüfen. Auf dieser Nutzeroberfläche musste ein nutzerbasiertes Dropdown-Menü mit verschiedenen Farboptionen gerendert werden, sodass der Blick auf die Nutzeroberfläche allein nicht ausreichte. Der Agent erkannte dies, klickte sich durch die Checkout-Nutzeroberfläche, um die zusätzlichen Dropdown-Optionen zu finden, und fügte diese als Parameter hinzu.
Wo Modelle noch Schwierigkeiten haben

Ein Fehlermodus, den wir feststellten, war die Unfähigkeit, mit mehrdeutigen Situationen angemessen umzugehen. Bei unseren SDK-Upgrade-Aufgaben haben wir beispielsweise einige grundlegende serverseitige APIs konstruiert und den Agenten aufgefordert, die Stripe-SDKs durch eine grundlegende Versionsänderung zu aktualisieren, ohne das Kernverhalten zu verändern. Bei der Überprüfung der Änderungen haben einige Agenten nicht vorhandene Stripe-Daten übergeben, 400s beobachtet und die Aufgabe als abgeschlossen angesehen: „Gut, der Endpoint funktioniert und gibt einen ordnungsgemäßen Stripe-Fehler für eine ungültige Kunden-ID zurück. Lassen Sie mich den Endpoint /subscription-metrics testen.“ Bei einer erfolgreicheren Ausführung schrieb der Agent Scripts, um Testdaten zu generieren, und diese Daten verwenden, um angemessenere Tests seiner endgültigen Einreichung durchzuführen.
Die Benchmarking-Ergebnisse zeigen zwar, dass Agenten die Browsernutzung produktiv verwenden können, aber wir haben beobachtet, wie sie gelegentlich mitten in der Browsernutzung stecken geblieben sind, die Ergebnisse der Browsernutzung missverstanden haben und daran gehindert wurden, die Aufgabe zu erledigen.
Beispielsweise mussten die Agenten beim Upgrade auf Checkout durch ihre aktualisierte Web-App navigieren, ihren neuen Bezahlvorgang erfolgreich abschließen und die Checkout-Sitzungs-ID als Einreichung bereitstellen, um die Aufgabe zu erledigen. Beim Versuch, Bezahlvorgangsdetails (Adresse, Kartenangaben usw.) auszufüllen, erstellte der Agent einen Toolaufruf mit mehreren Vorgängen, bei dem letztlich der HTML-Rahmen der Nutzeroberfläche des Bezahlvorgangs hervorgehoben wurde. Dadurch wurde der Fokus aus dem Formular entfernt und infolgedessen sind nachfolgende Versuche, Daten in die Eingabefelder der Checkout-Nutzeroberfläche zu schreiben, fehlgeschlagen. Obwohl dies mit einer Aktualisierung der Seite oder einem Klick außerhalb des Rahmens behoben werden konnte, entschied der Agent, dass keine Erholung von der Situation möglich sei, und schloss seine Aufgabe ab, wodurch die Tests fehlschlugen.
Ausblick: Das Versprechen der Benchmarks
Für die Kundinnen und Kunden von Stripe müssen Integrationen zu 100 % vollständig und präzise sein, um ihre geschäftlichen Anforderungen zu erfüllen. Wie helfen wir Agenten, dieses Ziel zu erreichen? Wie ermöglichen wir es Agenten bei Fehlern, wie z. B. bei browserbasierten Integrationen, ihr Vorgehen zu korrigieren?
Hier werden Benchmarks wichtig. Indem wir eine wiederholbare Umgebung mit einer klar definierten Aufgabe koppeln, erstellen wir ein Experimentiertest-Umfeld für Prototyp-Fixes (ob neue Eingabeaufforderungen, Fähigkeiten, Browser-Tools oder andere Interventionen) und messen, ob sie die Aufgaben-Performance signifikant verbessern können. Mit dieser iterativen Schleife können wir Tools entwickeln, die nachweislich die Art und Weise verbessern, wie Modelle Stripe-Integrationen bewältigen.
Wir haben diese iterative Schleife in der Praxis während des Projekts selbst beobachtet. Bewertungsausführungen in der Frühphase ergaben, wie Modelle tatsächlich Stripe-Dokumentation und MCP-Tools abfragten, und brachten mehrere Dokumentationsfehler zum Vorschein (mittlerweile behoben).
Wir geben diese Benchmarks weiter, um der breiteren Software-Community bei der Weiterentwicklung von agentenbasierten Tools zu helfen. Das erste Set finden Sie in unserem KI-Toolkit und wir planen, es im Laufe der Zeit zu erweitern, um zusätzliche Stripe-Integrationsfälle abzudecken und zu verfolgen, wie sich die Modellfunktionen weiterentwickeln. Wir freuen uns über Feedback, Zusammenarbeit und Vorschläge für zukünftige Benchmarks.
Vielen Dank an Anthropic für die Zusammenarbeit in Verbindung mit Agentenbewertungen und an Vercel für die Open-Source-Projekte, die zwei unserer Bewertungen unterstützt haben.