Agentes de IA conseguem criar integrações reais da Stripe? Criamos um benchmark para descobrir


Os LLMs de última geração agora podem resolver a maioria dos problemas de codificação delimitados, desde a implementação de funções até a refatoração no nível do arquivo. Porém, ainda há uma lacuna não quantificada entre essa capacidade de codificação e a habilidade de gerenciar de forma totalmente autônoma projetos de engenharia de software.
A engenharia de software no mundo real é uma atividade de longo prazo que exige planejamento, gestão persistente de estado e recuperação de falhas. Mesmo para uma API como a da Stripe, que foi criada para ser fácil de usar, a entrega de uma integração de ponta a ponta envolve muito trabalho de "conexão" entre domínios, como lidar com novas APIs, testar frontends e migrar bancos de dados.
Queríamos responder a esta pergunta: agentes conseguem criar integrações completas da Stripe de forma autônoma? Quando se trata de empresas que operam na Stripe, uma integração quase correta é uma falha; pagamentos exigem 100% de precisão. O que importa não é apenas a habilidade de um agente gerar código, mas sua capacidade de verificar, testar e validar esse código com o rigor de um engenheiro humano. Para avaliar isso, buscamos responder a algumas perguntas relacionadas:
- O quanto os modelos entendem a API da Stripe?
- Agentes conseguem criar código correto para os componentes de backend e frontend de uma integração da Stripe?
- Por fim, eles conseguem lidar com o trabalho de conexão de ponta a ponta, como atualizar pacotes, fazer a gestão do estado do banco de dados e verificar se a integração realmente funciona em um navegador?
Criamos um conjunto de ambientes e desafios de avaliação que reproduzem a natureza da criação de uma integração full-stack com a Stripe, exigindo o uso de bases de código completas, scripts, navegadores e pesquisa na documentação. O resultado é o benchmark de integração da Stripe, um dos primeiros benchmarks de desenvolvimento com agentes para APIs em um ambiente realista de produção. Nossa pesquisa revela o que esses modelos fazem bem, onde eles falham e por que medir a execução no mundo real é muito mais difícil do que parece, especialmente quando as tarefas são ambíguas e o sucesso exige verificação de ponta a ponta.
Como construímos o benchmark de integração da Stripe
Com uma equipe de engenheiros de produto e de suporte técnico, pensamos em casos de uso que representam desafios reais de integração que uma empresa na Stripe pode enfrentar, como migrar os fluxos do Stripe Checkout ou modelar seu modelo de negócio com nossas APIs do Stripe Billing. Depois, desenvolvemos 11 ambientes diferentes com tarefas de integração da Stripe para o agente realizar. Cada avaliação seguiu esta estrutura:
- Ambiente: um ambiente de codificação completo com código, bancos de dados e scripts que representam um repositório inicial típico para um projeto de integração da Stripe. Esse ambiente também inclui chaves de API de teste da Stripe que o agente pode usar para testes e validação do envio do desafio.
- Avaliadores: os componentes de avaliação automatizada usados para pontuar um envio. Na maioria dos desafios, os avaliadores foram implementados como testes determinísticos que executaram o software finalizado por meio de chamadas de API, testes automatizados de IU ou ambos. Alguns avaliadores também validaram os artefatos da Stripe de uma execução ao inspecionar os objetos de API da Stripe criados. Por exemplo, em um desafio full-stack, o agente poderia concluir um pagamento na IU e depois verificar o sucesso ao testar um objeto da API Checkout Session correspondente em modo de teste e bem-sucedido na Stripe.
- Estrutura do agente: o tempo de execução das ferramentas e ações que o LLM deve realizar. Para oferecer uma estrutura consistente a todos os modelos, usamos uma baseada no goose para todas as execuções de avaliação e fornecemos aos modelos um servidor do Model Context Protocol (MCP) que concede acesso a um terminal, um navegador e ferramentas de pesquisa específicas da Stripe.
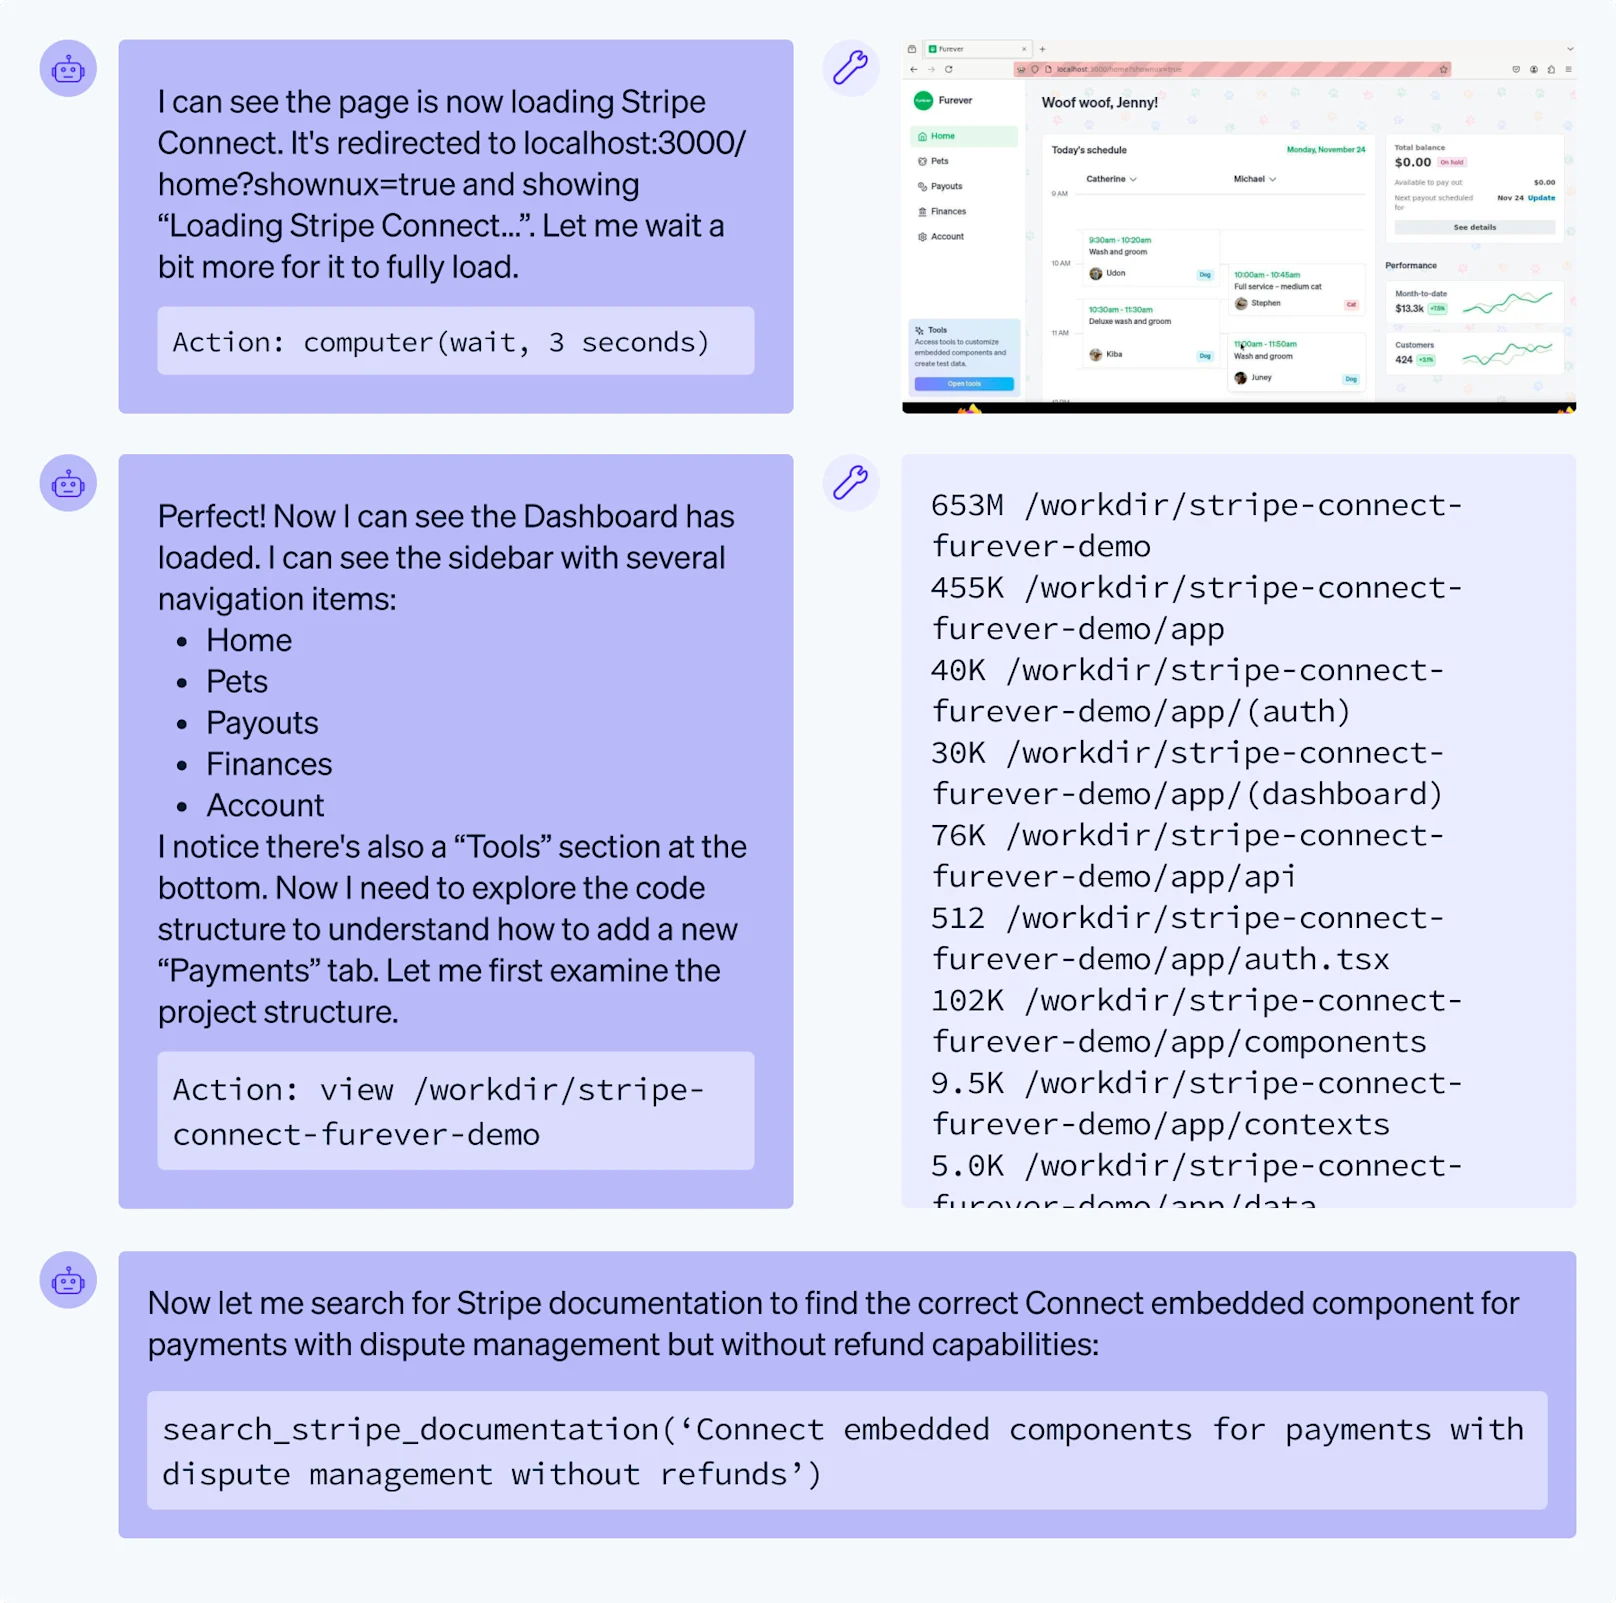
Esquema de avaliação e trecho representativo de uma transcrição de execução de um agente
O desenvolvimento desses desafios robustos exigiu um trabalho técnico comparável à criação de um software real. Os ambientes precisavam ser realisticamente complexos (vários arquivos, scripts, bancos de dados), mas estruturados o suficiente para aceitar um avaliador limpo que não fosse ambíguo e permitisse execuções de avaliação replicáveis. Nossos desafios de integração abrangem três categorias principais:
- Tarefas apenas de backend: tarefas focadas em integrações da Stripe no servidor, como concluir migrações de dados, lidar com mudanças de versão da API da Stripe e atualizar APIs de backend.
- Tarefas full-stack: tarefas que envolvem integrações da Stripe com um componente do servidor e uma integração do cliente. Elas exigem o uso do navegador para o envio final.
- Conjuntos de problemas de laboratório: conjuntos de exercícios simulados focados em uma parte específica do conjunto de recursos da Stripe (nosso "laboratório"), como Checkout ou assinaturas. Eles buscam aprofundar o entendimento e abrangem configurações mais avançadas desses produtos, como a personalização das taxas de envio para o Checkout ou a alteração dos comportamentos de avaliação gratuita nas assinaturas.
Principais descobertas
Ao desenvolver esse benchmark, decidimos focar na dificuldade e criamos um número menor de tarefas mais difíceis com o objetivo de desafiar os modelos. Com base em avaliações rudimentares de modelos de última geração em meados de 2025, esperávamos um desempenho aceitável em tarefas apenas de backend e antecipamos que os modelos teriam dificuldade para lidar com o desenvolvimento full-stack.
Por outro lado, os resultados nos surpreenderam: os modelos navegaram por IUs, depuraram problemas em produção e até lidaram com comportamentos pouco documentados. Descobrimos que o Claude Opus 4.5 foi muito eficiente nas tarefas full-stack de integração de API (pontuação média de 92% em 4 tarefas), e o GPT-5.2 da OpenAI se destacou nos conjuntos de problemas da "academia" (pontuação média de 73% em 2 tarefas). Todos os modelos avaliados conseguiram trabalhar de forma produtiva por longos períodos, e as execuções com melhor desempenho tiveram em média 63 interações.


O que foi muito interessante foi ver como os modelos superaram nossas expectativas. Com os agentes que testamos, vimos momentos claros de proficiência em engenharia full-stack. Na tarefa "do elemento de cartão para a sessão de checkout", os agentes primeiro atualizaram uma integração de uma IU legada do Card Element para o Checkout.

Em seguida, foi solicitado que eles verificassem a alteração por conta própria ao concluir uma compra de teste no navegador. Embora não tenhamos especificado uma forma de pagamento, em uma execução, o agente usou o Link (uma carteira digital desenvolvida pela Stripe) com sucesso para concluir o checkout de ponta a ponta.

Outro ponto positivo surpreendente no desempenho dos agentes foi a tarefa da academia de checkout. Nessa avaliação, pedimos aos agentes para fazer a engenharia reversa das chamadas de API de 20 IUs predefinidas do Checkout. Para obter a resposta correta, os agentes precisavam concluir algumas etapas. Primeiro, eles precisavam explorar a página da Web da sessão de checkout para ver quais produtos e quantidades foram selecionados para a compra. Depois, para encontrar os IDs dos produtos a serem passados como parâmetros, eles precisavam localizá-los no catálogo de produtos armazenado na API Products. Em seguida, os agentes precisavam identificar todas as personalizações usadas na sessão, como valores de envio, campos personalizados e se a cobrança de impostos estava habilitada. Por fim, eles precisavam converter cada produto e recurso no parâmetro correto a partir das várias configurações que temos em nossa API Checkout Session.
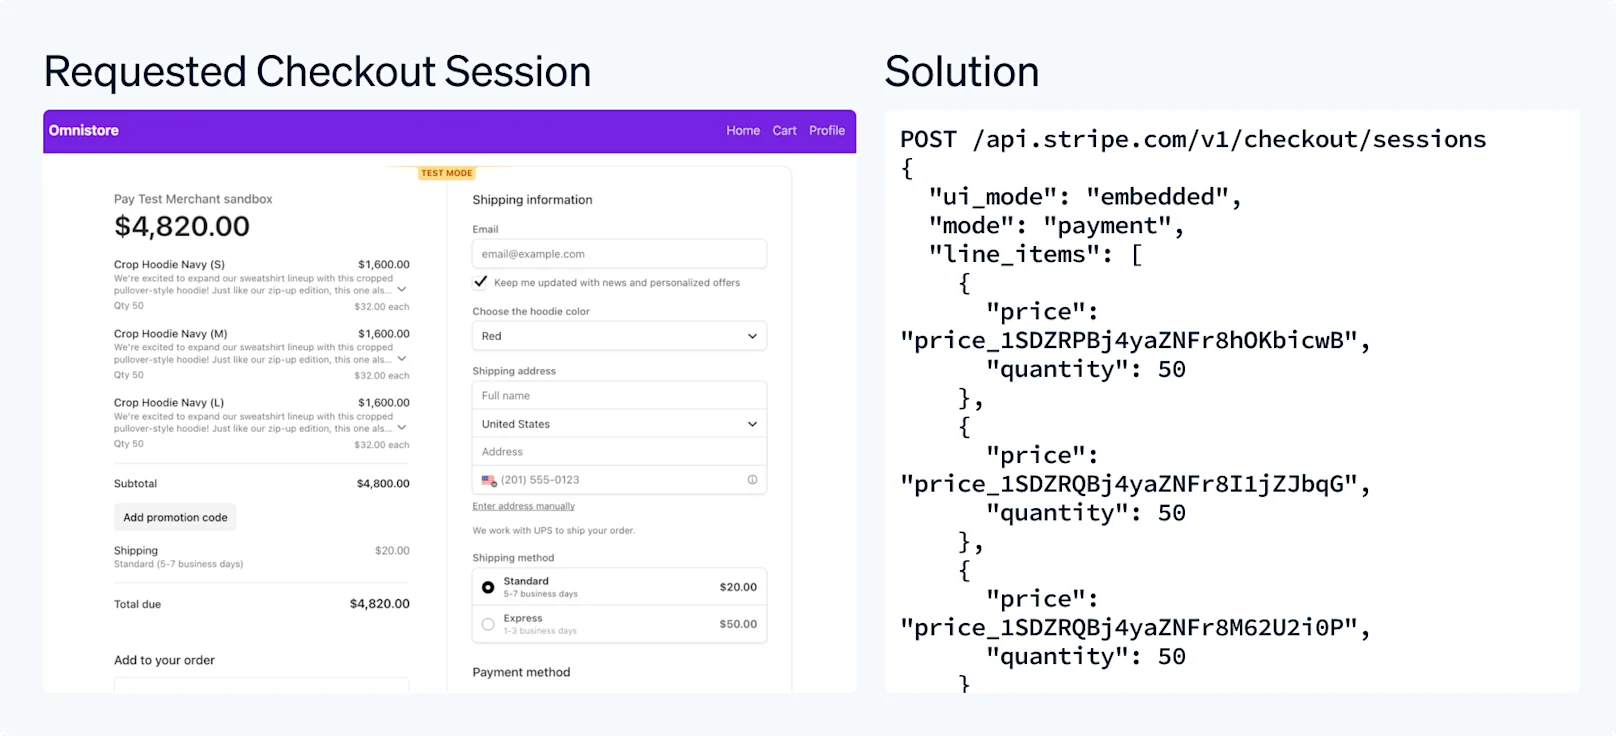
Um exemplo de tarefa de checkout para uma academia. Para obter sucesso, é necessário configurar corretamente o Checkout Session e identificar o objeto correto da API Products a ser passado como parâmetro.
Em nossas avaliações, os agentes conseguiram realizar essa tarefa, pois forneceram mais de 80% dos parâmetros corretos. Para uma das IUs mais complexas do Checkout, além de seguir todas as etapas descritas acima, o agente com melhor desempenho conseguiu conferir o próprio trabalho em configurações mais avançadas. Nessa IU, tínhamos um menu suspenso personalizado renderizado com diferentes opções de cor, por isso apenas visualizar a IU não era o bastante. O agente percebeu isso, clicou na IU do Checkout para encontrar as opções adicionais do menu suspenso e as adicionou como parâmetros.
Onde os modelos ainda têm dificuldade

Um modo de falha que notamos foi a incapacidade de lidar com situações ambíguas de forma sensata. Por exemplo, em nossas tarefas de atualização de SDK, construímos algumas APIs básicas no servidor e pedimos ao agente que atualizasse os SDKs da Stripe por meio de uma alteração de versão com incompatibilidade sem mudar o comportamento principal. Ao verificar as mudanças, alguns agentes repassavam dados inexistentes da Stripe, observavam erros 400 e consideravam a tarefa concluída: "Ótimo, o endpoint está funcionando, pois retorna um erro adequado da Stripe para um ID de cliente inválido. Vou testar o endpoint /subscription-metrics..." Em uma execução com mais sucesso, o agente escreveria scripts para gerar dados de teste e usaria essas informações para fazer testes mais válidos de seu envio final.
Além disso, embora os resultados do benchmark mostrem que os agentes conseguem aproveitar o uso do navegador de forma produtiva, percebemos que eles costumam travar durante a utilização, interpretam mal os resultados do navegador e são impedidos de concluir a tarefa.
Por exemplo, os agentes que atualizavam para o Checkout precisavam navegar pelo aplicativo da Web atualizado, concluir o novo fluxo de checkout com sucesso e informar o ID da sessão de checkout como um envio para finalizar a tarefa. Ao tentar preencher os dados do checkout (endereço, dados do cartão, etc.), o agente criou uma chamada de ferramenta com várias operações que acabou destacando a moldura de HTML da IU do checkout. Isso tirou o foco do formulário e, como resultado, as tentativas seguintes de inserir dados nos campos de entrada da IU do Checkout falharam. Embora isso pudesse ser resolvido se a página fosse recarregada ou com um clique fora da moldura, o agente decidiu que não conseguiria se recuperar da situação e concluiu a tarefa, com reprovação nos testes.
Perspectivas: a promessa dos benchmarks
Para clientes da Stripe, as integrações precisam ser 100% completas e precisas para as necessidades de seus negócios. Como ajudamos os agentes a atingir esse nível? Quando ocorrem falhas, como no caso da navegação em integrações baseadas no navegador, como capacitamos os agentes para corrigir a rota?
É aqui que os benchmarks importam. Ao associar um ambiente passível de reprodução a uma tarefa bem definida, criamos uma base de testes de experimentação para prototipar correções (sejam novos prompts, habilidades, ferramentas de navegador ou outras intervenções) e avaliar se eles conseguem melhorar o desempenho da tarefa de forma expressiva. Com o tempo, esse ciclo iterativo nos permite criar ferramentas que melhoram comprovadamente a forma como os modelos se integram com a Stripe.
Observamos esse ciclo iterativo na prática durante o próprio projeto. As primeiras execuções de avaliação revelaram como os modelos realmente consultavam a documentação da Stripe e as ferramentas de MCP, além de indicarem vários bugs na documentação (que já foram corrigidos).
Vamos compartilhar esses benchmarks para ajudar toda a comunidade de software a aprimorar as ferramentas de agentes. O conjunto inicial está disponível em nosso kit de ferramentas de IA, e planejamos expandi-lo com o tempo para abranger mais casos de integração da Stripe e acompanhar como as capacidades dos modelos evoluem. Agradecemos feedback, colaboração e sugestões para benchmarks no futuro.
Agradecemos à Anthropic por sua colaboração nas avaliações com agentes e à Vercel pelos projetos de código aberto que serviram de base para duas das nossas avaliações.