¿Pueden los agentes de IA crear integraciones de Stripe reales? Creamos un banco de pruebas para averiguarlo


Los Grandes Modelos de Lenguaje (LLM, por sus siglas en inglés) de última generación ahora pueden resolver la mayoría de los problemas de codificación delimitados, desde la implementación de funciones hasta la refactorización a nivel de archivo. Pero aún existe una brecha no cuantificada entre esa funcionalidad de codificación y la capacidad de gestionar de forma totalmente autónoma proyectos de ingeniería de software.
La ingeniería de software del mundo real es una actividad a largo plazo que requiere planificación, gestión persistente del estado y recuperación después de un fallo. Incluso para una API como Stripe, que está diseñada para facilitar el uso, enviar una integración de extremo a extremo implica mucho trabajo entre dominios «encolado» entre el manejo de nuevas API, las pruebas de front ends y la migración de bases de datos.
Queríamos responder a esta pregunta: ¿pueden los agentes crear de forma autónoma integraciones completas de Stripe? Cuando se trata de empresas que funcionan con Stripe, una integración mayoritariamente correcta es un fracaso; los pagos requiere una precisión del 100 %. No sólo importa la capacidad de un agente para generar código, sino su capacidad para verificar, probar y validar ese código con el rigor de un ingeniero humano. Para evaluar esto, nos propusimos responder algunas preguntas relacionadas:
- ¿Cómo entienden los modelos la API de Stripe?
- ¿Los agentes pueden corregir el código en los componentes back-end y front-end de una integración de Stripe?
- Por último, ¿pueden encargarse de todo el trabajo de integración de principio a fin, como actualizar paquetes, gestionar el estado de la base de datos y comprobar que la integración funciona correctamente en un navegador?
Diseñamos un conjunto de entornos y desafíos de evaluación que reflejan la naturaleza para crear una integración de Stripe de pila completa, lo que requiere bases de código completas, programación, uso del navegador y búsqueda de documentación. El resultado es el punto de referencia de la integración de Stripe, uno de los primeros puntos de referencia de desarrollo de agentes para API en un entorno realista de producción. Nuestra investigación revela qué pueden hacer bien estos modelos, dónde se quedan cortos y por qué medir la ejecución en el mundo real es mucho más difícil de lo que parece, especialmente cuando las tareas son ambiguas y el éxito requiere una verificación de extremo a extremo.
Cómo hemos creado el punto de referencia de la integración de Stripe
Con un equipo de ingenieros de producto y soporte técnico, hicimos una lluvia de ideas sobre casos de uso que representan desafíos de integración reales a los que podría enfrentarse una empresa en Stripe, como migrar sus flujos de Stripe Checkout o crear su modelo de negocio con nuestras la API Stripe Billing. Luego desarrollamos 11 entornos diferentes con tareas de integración de Stripe para que el agente las lleve a cabo. Cada evaluación siguió esta estructura:
- Entorno: un entorno de programación completo con código, bases de datos y scripts que representan un repositorio inicial típico para un proyecto de integración de Stripe. Este entorno también incluye claves API de Stripe de prueba que el agente podría usar para validar pruebas y enviar desafíos.
- Clasificadores: los componentes de evaluación automatizada utilizados para puntuar un envío. En la mayoría de los desafíos, los calificadores se implementaron como pruebas determinantes que ejercían el software terminado mediante llamadas a la API, pruebas de interfaz de usuario automatizadas o ambas. Algunos calificadores también validaron los artefactos Stripe de una ejecución inspeccionando los objetos de la API de Stripe creados. Por ejemplo, en un desafío de pila completa, el agente podría completar un pago en la interfaz de usuario y luego verificar el éxito probando un objeto API correspondiente en modo de prueba en la sesión de proceso de compra en Stripe.
- Arnés de seguridad del agente: tiempo de ejecución de las herramientas y acciones que debe llevar a cabo el LLM. Para dar a todos los modelos un arnés de seguridad coherente, utilizamos un arnés basado en goose para todas las pruebas de evaluación y proporcionamos a los modelos un servidor Model Context Protocol (MCP) que da acceso a un terminal, a un navegador y a herramientas de búsqueda específicas de Stripe.
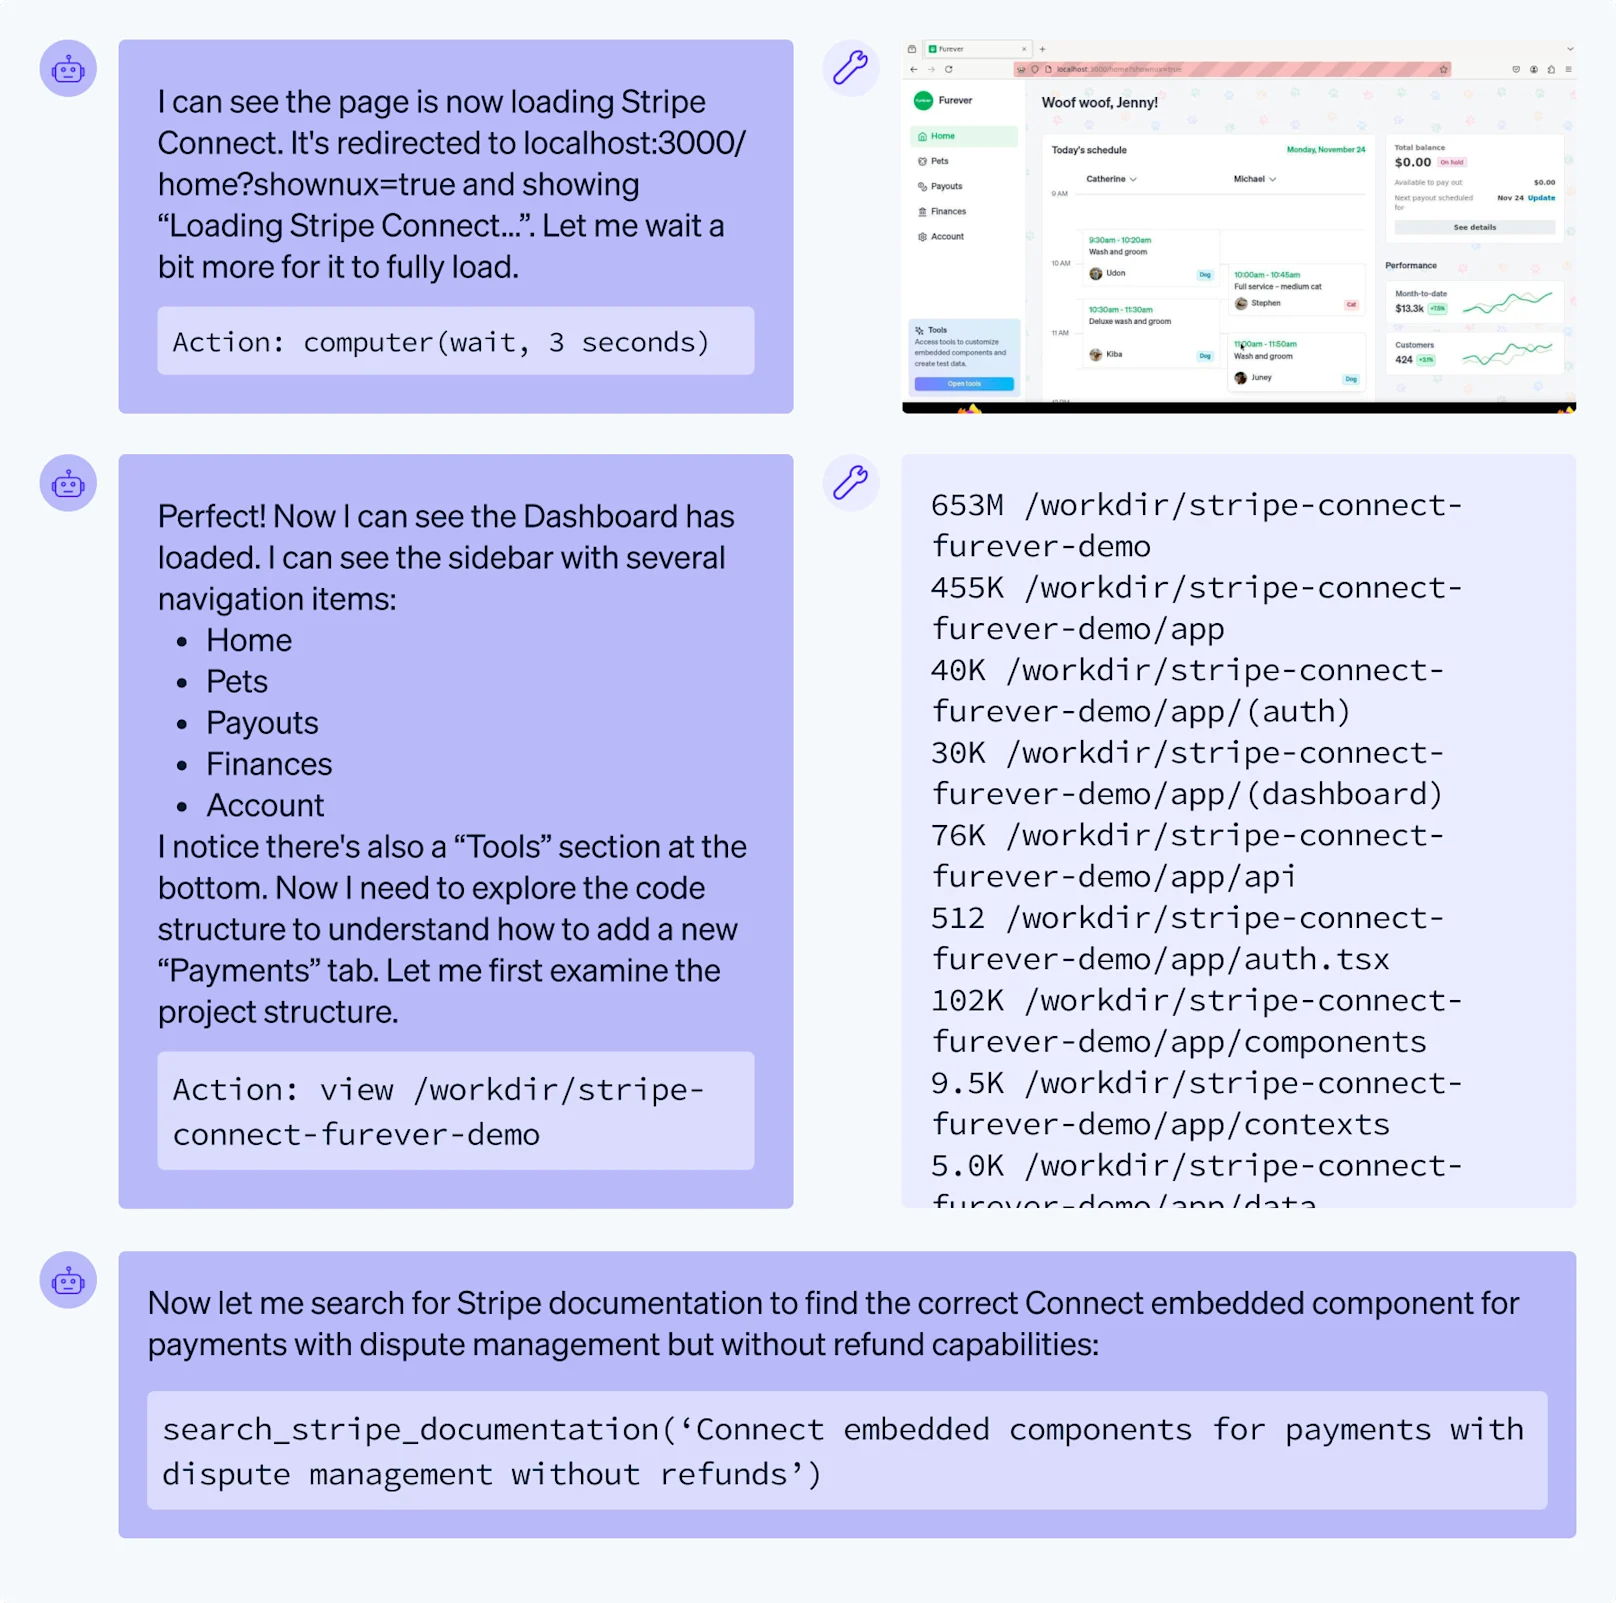
Esquema de evaluación y fragmento representativo de la transcripción de ejecución de un agente
El desarrollo de estos sólidos desafíos requería un trabajo técnico comparable al de la creación de software real. Los entornos tenían que ser complejos y realistas (múltiples archivos, scripts, bases de datos), pero lo suficientemente estructurados como para admitir un calificador limpio que no tuviera ambigüedades y permitiera ejecuciones de evaluación replicables. Nuestros desafíos de integración abarcan tres categorías principales:
- Tareas solo de back end: tareas centradas en la integración de Stripe del lado del servidor, como completar las migraciones de datos, gestionar los cambios de versión de la API de Stripe y actualizar las API de back end.
- Tareas de pila completa: tareas que implican integraciones de Stripe con un componente del lado del servidor y una integración del lado del cliente. Requieren el uso del navegador para el envío final.
- Conjuntos de problemas de gimnasio: conjuntos de ejercicios simulados centrados en una parte específica del conjunto de funciones de Stripe (nuestro «gimnasio») como procesos de compra o suscripciones. Estos facilitan una comprensión más profunda al cubrir configuraciones más avanzadas de estos productos, como personalizar las tarifas de envío para el pago o cambiar los comportamientos de prueba gratuita en las suscripciones.
Principales conclusiones
Al desarrollar este punto de referencia, decidimos inclinarnos hacia la dificultad y desarrollamos menos tareas más difíciles con el objetivo de hacer tropezar a los modelos. De acuerdo con las evaluaciones rudimentarias de modelos de última generación a mediados de 2025, esperábamos un rendimiento decente en las tareas solo de back end y anticipamos que los modelos tendrían dificultades con las disputas de pila completa.
En cambio, los resultados sorprendieron nos sorprendieron: los modelos navegaron por las interfaces de usuario, depuraron problemas activos e incluso manejaron un comportamiento poco documentado. Descubrimos que Claude Opus 4.5 era particularmente hábil con las tareas de integración de la API de pila completa (con una puntuación promedia del 92 % en 4 tareas), mientras que el GPT-5.2 de OpenAI sobresalió en conjuntos de problemas de «gimnasio» (con una puntuación promedia del 73 % en 2 tareas). Todos los modelos evaluados pudieron trabajar de manera productiva durante largas duraciones con las ejecuciones con el mejor rendimiento, con un promedio de 63 turnos.


Fue particularmente interesante ver cómo los modelos superaban nuestras expectativas. De los agentes que probamos, vimos momentos claros de competencia en ingeniería de pila completa. En la tarea «card element to checkout session», los agentes primero actualizaron una integración de una interfaz de usuario heredada Card Element al proceso de compra.

Después se les pidió que se autoverificaran el cambio completando una compra de prueba en el navegador. Aunque no especificamos un método de pago, en una ejecución el agente utilizó con éxito Link, un monedero digital creado por Stripe para completar el proceso de compra de extremo a extremo.

Otro punto sorprendente en el rendimiento del agente fue la tarea de checkout de gimnasio. En esta evaluación, pedimos a los agentes que anularan las llamadas a la API detrás de 20 interfaces de usuario de checkout prediseñadas. Para obtener la respuesta correcta, los agentes tendrían que cumplir unos pasos. Primero, tendrían que explorar la página web de Checkout Session para ver qué productos y cantidades se seleccionaron para la compra. Luego, a fin de encontrar los ID de producto para pasarlos como parámetros, tendrían que encontrarlos en el catálogo de productos almacenado en la API Products. A continuación, los agentes tendrían que discernir todas las personalizaciones de sesión utilizadas, desde los importes de envío, los campos personalizados y si se habilitó el cobro de impuestos. Finalmente, tendrían que convertir cada producto y función en el parámetro correcto de las diversas configuraciones que tenemos en nuestra API Checkout Session.
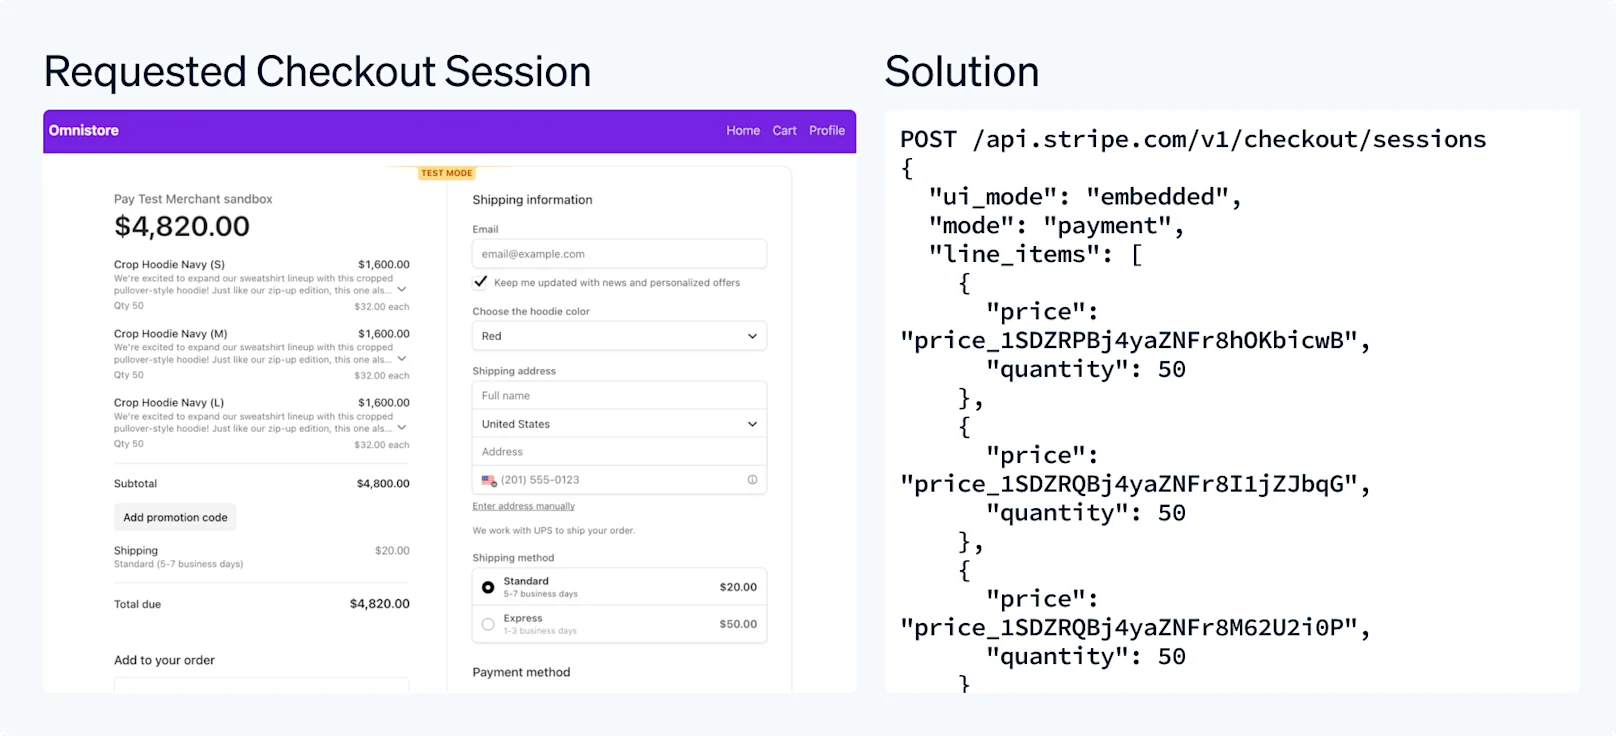
Un ejemplo de tarea de entrenamiento del proceso de compra. Las soluciones eficaces requieren tanto la configuración correcta de Checkout Session como la identificación del objeto correcto de la API Products para pasarlos como parámetros.
En nuestras evaluaciones, los agentes pudieron navegar por esta tarea proporcionando más del 80 % de los parámetros correctos. Para una de las interfaces de proceso de compra más complejas, además de seguir todos los pasos descritos anteriormente, el agente con el mejor rendimiento pudo comprobar de nuevo su trabajo en configuraciones más avanzadas. En esta interfaz de usuario, teníamos un menú desplegable personalizado con diferentes opciones de color, por lo que mirar solo la interfaz de usuario fue insuficiente. El agente se dio cuenta de esto, hizo clic en la interfaz de usuario del proceso de compra para encontrar las opciones desplegables adicionales y las añadió como parámetros.
En qué punto los modelos siguen teniendo dificultades

Un modo de fallo del que nos percatamos fue la incapacidad de gestionar con sensatez las situaciones ambiguas. Por ejemplo, en nuestras tareas de actualización de SDK, construimos unas cuantas API básicas del lado del servidor y pedimos al agente que actualizara los SDK de Stripe a través de un cambio radical de versión, pero sin cambiar el comportamiento principal. Al verificar los cambios, algunos agentes introducían datos inexistentes de Stripe, observaban errores 400 y daban la tarea por concluida: «Bien, el punto de conexión funciona: devuelve un error de Stripe adecuado para un ID de cliente no válido. Voy a probar el punto de conexión /subscription-metrics…». En una ejecución más exitosa, el agente escribiría scripts para generar datos de prueba y los usaría para hacer pruebas más válidas de su envío final.
Además, aunque los resultados de la evaluación comparativa muestran que los agentes tienen la capacidad de aprovechar el uso del navegador de manera productiva, observamos que, a veces, se quedan atrapados en el medio del uso del navegador, con malentendidos en las salidas de uso del navegador y se les bloquea la tarea.
Por ejemplo, los agentes que se actualizaban al checkout tenían que navegar a través de su solicitud de acceso actualizada, completar correctamente el nuevo flujo del proceso de compra y proporcionar el ID de la sesión del proceso de compra como envío para completar la tarea. Al intentar completar los datos del proceso de compra (dirección, datos de la tarjeta, etc.), el agente creó una llamada a la herramienta con varias operaciones que terminaron destacando el marco HTML de la interfaz de usuario del checkout. Esto eliminó el foco del formulario y, como resultado, falló en los intentos posteriores de escribir datos en los campos de entrada de la interfaz de usuario del checkout. Aunque esto se pudo corregir actualizando la página o haciendo clic fuera del marco, el agente decidió que no podía recuperarse de la situación y concluyó su tarea al no pasar las pruebas.
De cara al futuro: la promesa de establecer una referencia
Para los clientes de Stripe, las integraciones deben ser 100 % completas y precisas según las necesidades de su empresa. ¿Cómo ayudamos a los agentes a llegar a ese nivel? Cuando se producen fallos, como en el caso de la navegación por integraciones basadas en el navegador, ¿cómo habilitamos a los agentes para que funcionen correctamente?
Aquí es donde los puntos de referencia cobran importancia. Al emparejar un entorno reproducible con una tarea bien definida, creamos un banco de pruebas de experimentación para crear prototipos de correcciones (ya sean nuevos avisos, habilidades, herramientas del navegador u otras intervenciones) y medir si pueden mejorar significativamente el rendimiento de las tareas. Con el tiempo, este bucle iterativo nos permite crear herramientas que mejoren de manera demostrable cómo se integran los modelos con Stripe.
Observamos este bucle iterativo en la práctica durante el propio proyecto. Las primeras ejecuciones de evaluación revelaron cómo los modelos realmente consultaban la documentación Stripe y las herramientas MCP y surgieron varios errores de documentación (desde entonces corregidos).
Compartimos estos puntos de referencia para ayudar a la comunidad de software en general a mejorar las herramientas de agentes. El conjunto inicial está disponible en nuestro kit de herramientas de IA y planeamos ampliarlo con el tiempo para cubrir casos adicionales de integración de Stripe y observar cómo evolucionan las funcionalidades del modelo. Agradecemos comentarios, colaboración y sugerencias para futuros puntos de referencia.
Gracias a Anthropic por su colaboración en evaluaciones de agencias y a Vercel por los proyectos de fuente abierta que han apoyado dos de nuestras evaluaciones.