Gli agenti di IA possono creare integrazioni Stripe reali? Abbiamo realizzato un benchmark per scoprirlo


Gli LLM all'avanguardia ora sono in grado di risolvere la maggior parte dei problemi di programmazione circoscritti, dall'implementazione di funzioni alla rifattorizzazione a livello di file. Tuttavia, rimane un divario non quantificato tra questa capacità di programmazione e la capacità di gestire in modo completamente autonomo progetti di ingegneria del software.
L'ingegneria del software in contesti reali è un'attività a lungo termine che richiede pianificazione, gestione persistente dello stato e capacità di recuperare dagli errori. Anche per un'API come quella di Stripe, progettata per essere facile da usare, lo sviluppo di un'integrazione end-to-end implica molto lavoro di raccordo tra diversi ambiti, dalla gestione di nuove API al test dei front-end e alla migrazione dei database.
Volevamo rispondere a questa domanda: gli agenti possono creare in modo autonomo integrazioni Stripe complete? Per le attività che usano Stripe, un'integrazione quasi corretta è un fallimento, i pagamenti richiedono una precisione del 100%. Ciò che conta non è solo la capacità di un agente di generare codice, ma anche la sua capacità di verificare, testare e convalidare quel codice con il rigore di un ingegnere umano. Per valutarlo, abbiamo cercato di rispondere ad alcune domande correlate:
- In che misura i modelli comprendono l'API Stripe?
- Gli agenti sono in grado di scrivere codice corretto per i componenti back-end e front-end di un'integrazione Stripe?
- Infine, sono in grado di gestire il lavoro di raccordo dall'inizio alla fine, aggiornando i pacchetti, gestendo lo stato del database e verificando che l'integrazione funzioni effettivamente in un browser?
Abbiamo creato una serie di ambienti e sfide di valutazione che rispecchiano le caratteristiche dello sviluppo di un'integrazione Stripe full-stack e richiedono intere basi di codice, scripting, uso del browser e ricerca nella documentazione. Il risultato è il benchmark per le integrazioni Stripe, uno dei primi benchmark di sviluppo per agenti per API in un ambiente realistico di produzione. La nostra ricerca mostra in quali ambiti questi modelli si dimostrano efficaci, dove incontrano difficoltà e perché valutare l'esecuzione in contesti reali è molto più difficile di quanto sembri, soprattutto quando le attività sono ambigue e il successo richiede una verifica dall'inizio alla fine.
Come abbiamo creato il benchmark per le integrazioni Stripe
Insieme a un team di ingegneri di prodotto e dell'assistenza tecnica, abbiamo individuato casi d'uso che rappresentano sfide di integrazione reali che un'attività su Stripe potrebbe dover affrontare, come la migrazione dei propri flussi Stripe Checkout o la definizione del proprio modello di business con le nostre API Stripe Billing. Poi abbiamo sviluppato 11 ambienti diversi con attività di integrazione Stripe che l'agente deve portare a termine. Ogni valutazione ha seguito questa struttura:
- Ambiente: un ambiente di programmazione completo con codice, database e script che rappresentano un tipico repository di partenza per un progetto di integrazione Stripe. Questo ambiente include anche chiavi API Stripe di prova che l'agente può utilizzare per i test e per convalida della soluzione inviata.
- Strumenti di valutazione: componenti automatici utilizzati per assegnare un punteggio a una soluzione proposta. Nella maggior parte delle sfide, questi strumenti erano implementati come test deterministici che verificavano il software completo tramite chiamate API o test automatici dell'interfaccia utente, o entrambi. Alcuni strumenti di valutazione controllavano anche i risultati prodotti su Stripe esaminando gli oggetti API generati. Ad esempio, in una sfida full-stack, l'agente poteva completare un pagamento nell'interfaccia utente e poi accertare il successo controllando la presenza in Stripe del corrispondente oggetto API Checkout Session in modalità di test.
- Harness per agenti: il runtime degli strumenti e delle azioni che l'LLM può eseguire. Per offrire a tutti i modelli un harness coerente, ne abbiamo utilizzato uno basato su goose per tutte le esecuzioni di valutazione e abbiamo fornito ai modelli un server Model Context Protocol (MCP) che garantisce l'accesso a un terminale, a un browser e a strumenti di ricerca specifici per Stripe.
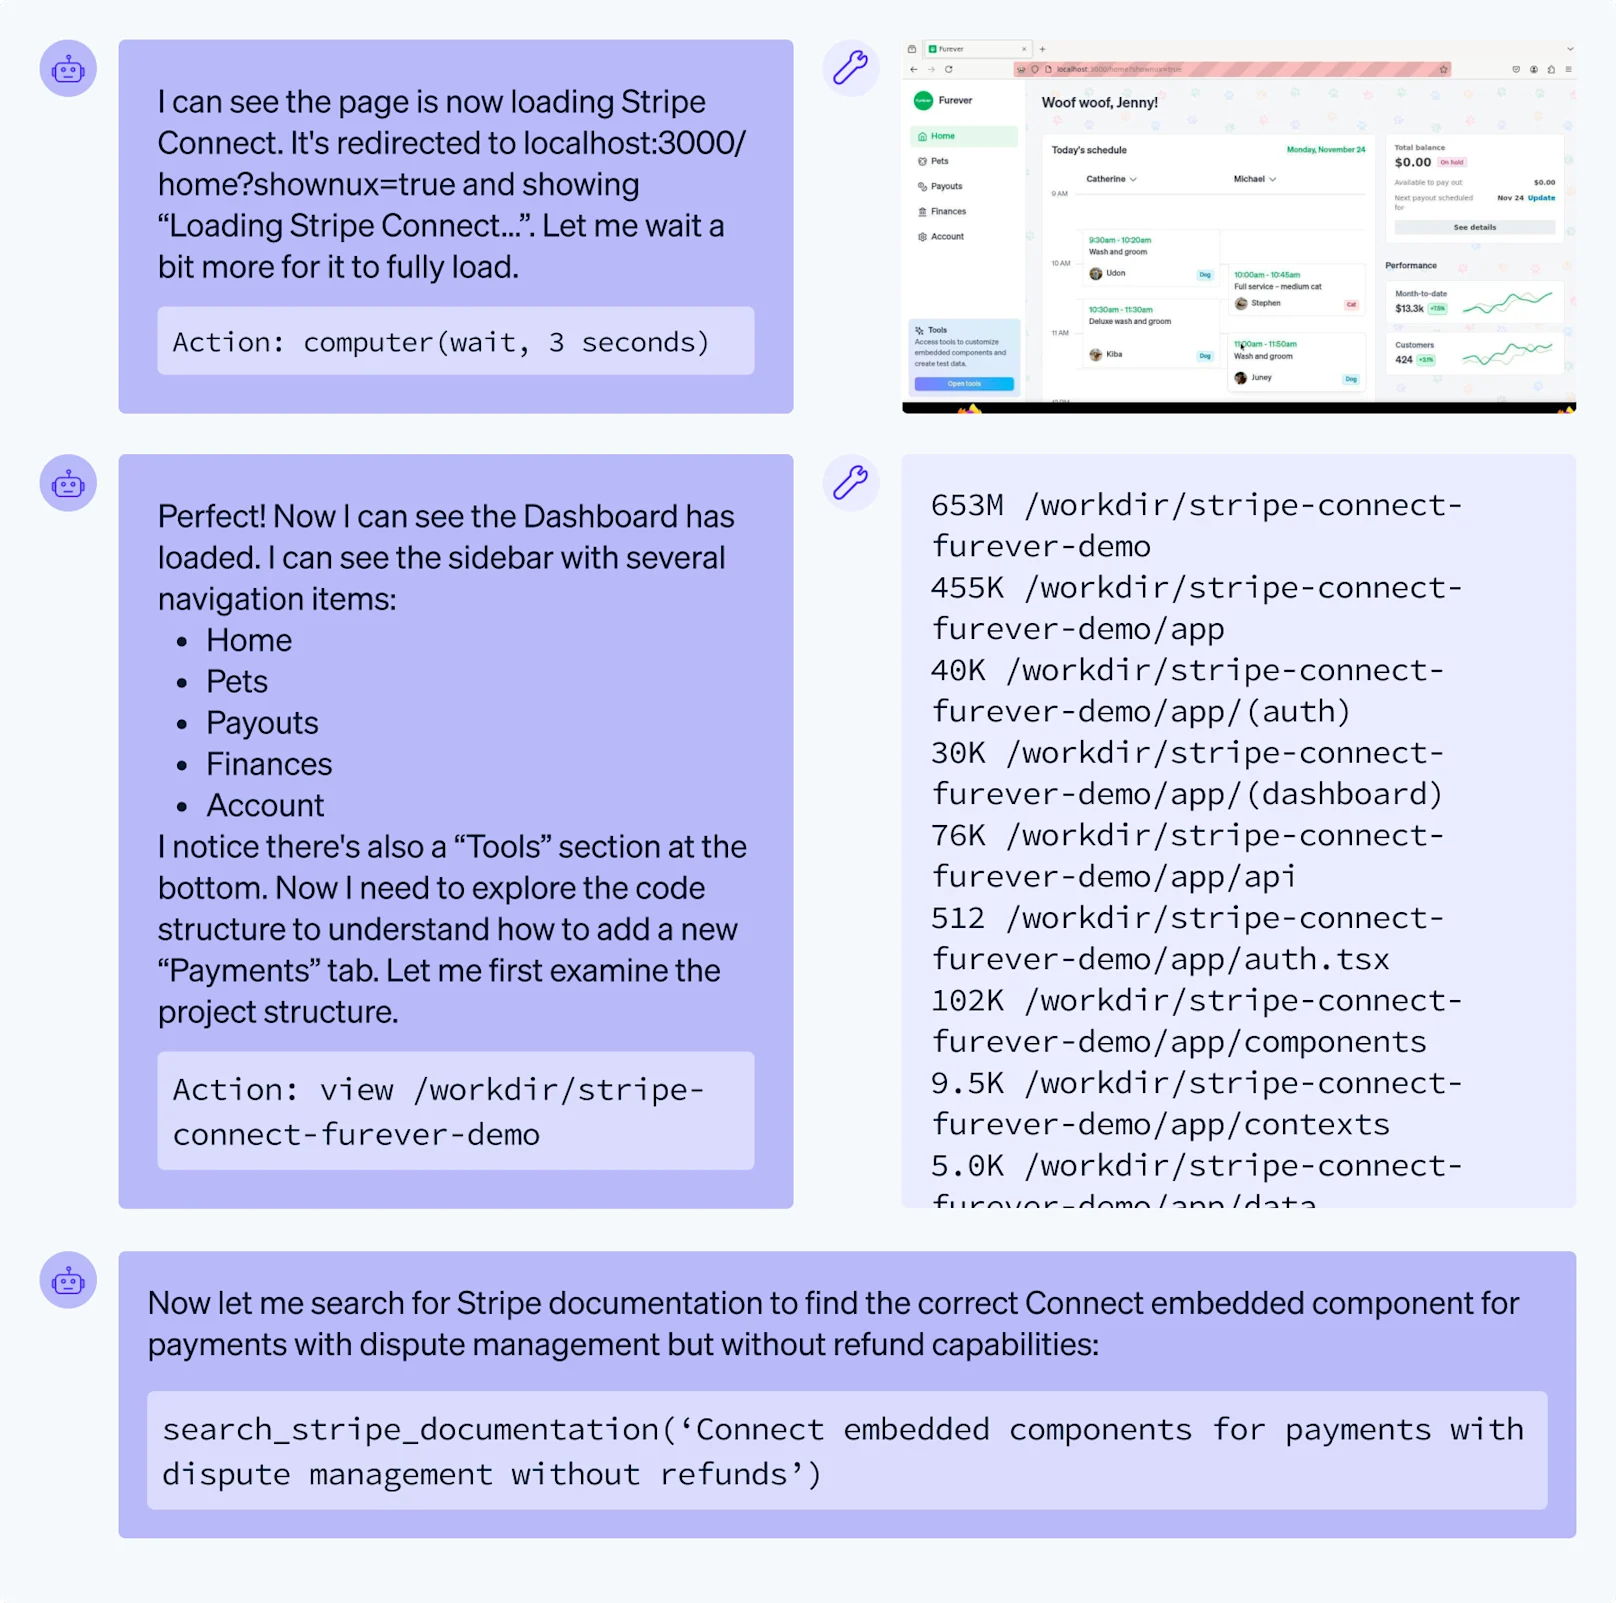
Schema della valutazione e frammento rappresentativo della trascrizione dell'esecuzione di un agente
Lo sviluppo di queste sfide complesse ha richiesto un lavoro tecnico paragonabile alla creazione di un vero e proprio software. Gli ambienti dovevano essere realisticamente complessi (file multipli, script, database), ma sufficientemente strutturati in modo da supportare uno strumento di valutazione chiaro e inequivocabile, che consentisse di ripetere le valutazioni nelle stesse condizioni. Le nostre sfide di integrazione rientrano in tre categorie principali:
- Compiti solo back-end: attività incentrate sull'integrazione Stripe lato server, come il completamento di migrazioni di dati, la gestione delle modifiche di versione dell'API di Stripe e l'aggiornamento delle API di back-end.
- Compiti full-stack: attività che prevedono integrazioni Stripe sia con un componente lato server che con un'integrazione lato client. Richiedono l'uso del browser per l'invio finale.
- Serie di esercizi pratici: serie di esercizi simulati incentrati su una parte specifica delle funzioni di Stripe (la nostra "palestra"), come Checkout o gli abbonamenti. Questi esercizi favoriscono una comprensione approfondita, trattando configurazioni più avanzate di questi prodotti, come la personalizzazione delle tariffe di spedizione per Checkout o la modifica dei comportamenti di prova gratuita negli abbonamenti.
Risultati principali
Nello sviluppare questo benchmark, abbiamo deciso di privilegiare la difficoltà e abbiamo sviluppato un numero inferiore di compiti più complessi con l'obiettivo di mettere alla prova i modelli. Sulla base di valutazioni preliminari dei modelli all'avanguardia a metà del 2025, ci aspettavamo prestazioni soddisfacenti nei compiti di solo back-end e prevedevamo che i modelli avrebbero incontrato difficoltà nella gestione full-stack.
I risultati ci hanno invece sorpreso: i modelli hanno saputo muoversi nelle interfacce utente, risolvere problemi in tempo reale e persino gestire comportamenti non documentati. Abbiamo riscontrato che Claude Opus 4.5 si è dimostrato particolarmente competente nelle attività di integrazione API full-stack (punteggio medio del 92% su 4 attività), mentre GPT-5.2 di OpenAI ha ottenuto risultati eccellenti nelle serie di esercizi pratici (punteggio medio del 73% su 2 attività). Tutti i modelli sottoposti a benchmarking sono stati in grado di lavorare in modo produttivo per periodi prolungati, con una media di 63 turni nelle esecuzioni migliori.


È stato particolarmente interessante vedere come i modelli abbiano superato le nostre aspettative. Tra gli agenti che abbiamo testato, abbiamo osservato chiari momenti di competenza nell'ingegneria full-stack. Nel compito "da Card Element a Checkout Session", gli agenti hanno prima aggiornato un'integrazione passando da una precedente interfaccia utente Card Element a Checkout.

Successivamente è stato chiesto loro di verificare autonomamente la modifica completando un acquisto di prova nel browser. Sebbene non avessimo specificato alcun metodo di pagamento, in una delle sue esecuzioni, l'agente ha utilizzato con successo Link, il wallet sviluppato da Stripe, per completare la procedura di pagamento dall'inizio alla fine.

Un altro aspetto sorprendente delle prestazioni degli agenti è stato il compito relativo alla procedura di pagamento nella sessione di esercizi pratici. In questa valutazione, abbiamo chiesto agli agenti di effettuare il reverse engineering delle chiamate API alla base di 20 interfacce utente di Checkout predefinite. Per ottenere la risposta corretta, gli agenti dovevano completare alcuni passaggi. In primo luogo, dovevano esplorare la pagina web di Checkout Session per verificare quali prodotti e quantità erano stati selezionati per l'acquisto. Successivamente, per individuare gli ID dei prodotti da trasmettere come parametri, dovevano cercarli nel catalogo prodotti memorizzato nell'API Products. Quindi, gli agenti dovrebbero individuare tutte le personalizzazioni utilizzate nella sessione, dagli importi di spedizione ai campi personalizzati, fino all'eventuale abilitazione della riscossione delle imposte. Infine, dovrebbero convertire ogni prodotto e funzione nel parametro corretto dalle varie configurazioni disponibili nella nostra API Checkout Session.
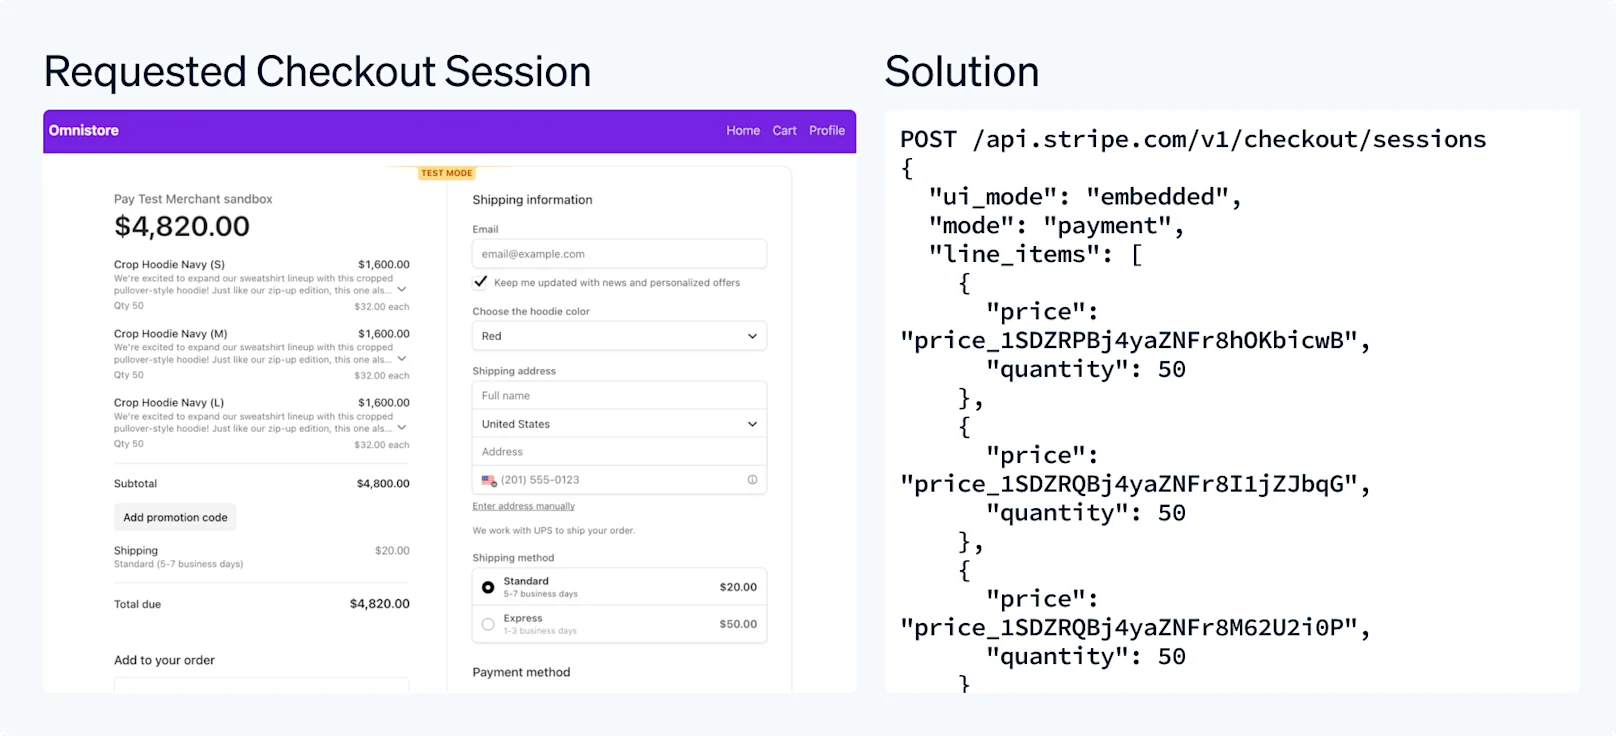
Un esempio di task di valutazione relativo al checkout. Per ottenere una soluzione corretta è necessario sia configurare correttamente la Checkout Session, sia individuare l'oggetto corretto dell'API Products da passare come parametro.
Nelle nostre valutazioni, gli agenti sono stati in grado di svolgere questo compito, fornendo oltre l'80% dei parametri corretti. Per una delle interfacce utente di Checkout più complesse, oltre a seguire tutti i passaggi sopra descritti, l'agente con le migliori prestazioni è stato in grado di ricontrollare il proprio lavoro su configurazioni più avanzate. In questa interfaccia utente, era presente un menu a discesa personalizzato con diverse opzioni di colore, pertanto non era sufficiente osservare solo l'interfaccia utente. L'agente se ne è accorto, ha fatto clic sull'interfaccia utente di Checkout per trovare le opzioni aggiuntive del menu a discesa e le ha aggiunte come parametri.
Dove i modelli hanno ancora difficoltà

Una modalità di errore che abbiamo osservato è stata l'incapacità di gestire in modo sensato situazioni ambigue. Ad esempio, nei nostri compiti di aggiornamento dell'SDK, abbiamo creato alcune API di base lato server e abbiamo chiesto all'agente di aggiornare gli SDK Stripe attraverso una modifica di versione che rompe la compatibilità senza cambiare il comportamento di base. Nel verificare le modifiche, alcuni agenti hanno trasmesso dati Stripe inesistenti, hanno osservato gli errori 400 e hanno considerato l'attività completata: "Bene, l'endpoint funziona: restituisce un errore Stripe corretto per un ID cliente non valido. Provo a testare l'endpoint /subscription-metrics". In un'esecuzione più riuscita, l'agente avrebbe scritto degli script per generare dati di prova e avrebbe utilizzato questi dati per eseguire test più validi dell'invio finale.
Inoltre, sebbene i risultati del benchmark mostrino che gli agenti sono in grado di utilizzare il browser in modo efficace, abbiamo osservato che occasionalmente rimanevano bloccati durante la navigazione, fraintendevano i risultati restituiti dal browser e non riuscivano a portare a termine il compito.
Ad esempio, gli agenti che effettuavano l'aggiornamento a Checkout dovevano navigare nella loro applicazione web aggiornata, completare correttamente il nuovo flusso di pagamento e fornire l'ID della Checkout Session come invio per completare l'attività. Nel tentativo di inserire i dati della procedura di pagamento (indirizzo, dati della carta, ecc.), l'agente ha creato una chiamata allo strumento con più operazioni che ha finito per evidenziare il frame HTML dell'interfaccia utente di Checkout. Ciò ha eliminato il focus dal modulo e, di conseguenza, i successivi tentativi di inserire i dati nei campi di immissione dell'interfaccia utente di Checkout non sono andati a buon fine. Sebbene fosse possibile risolvere il problema aggiornando la pagina o facendo clic all'esterno dal frame, l'agente ha ritenuto di non poter recuperare la situazione e ha concluso il compito, non superando i test.
Guardando al futuro: la promessa del benchmarking
Per i clienti Stripe, le integrazioni devono essere complete al 100% e accurate rispetto alle esigenze della loro attività. Come possiamo aiutare gli agenti a raggiungere questo livello? Quando si verificano errori, come nel caso della navigazione di integrazioni basate su browser, come possiamo consentire agli agenti di correggere la rotta?
È proprio qui che i benchmark diventano fondamentali. Abbinando un ambiente riproducibile a un compito ben definito, creiamo un banco di prova per sperimentare e prototipare correzioni (che si tratti di nuovi prompt, competenze, strumenti per il browser o altri interventi) e per misurare se migliorano concretamente le prestazioni nello svolgimento del compito. Nel tempo, questo ciclo iterativo ci consente di sviluppare strumenti che migliorano in modo dimostrabile il modo in cui i modelli si integrano con Stripe.
Abbiamo osservato questo ciclo iterativo concretamente durante il progetto. Le prime esecuzioni di valutazione hanno mostrato come i modelli interrogassero effettivamente la documentazione di Stripe e gli strumenti MCP, portando alla luce diversi bug nella documentazione, che sono stati risolti.
Condividiamo questi benchmark per supportare la più ampia comunità del software nell'avanzamento degli strumenti agentici. Il set iniziale è disponibile nel nostro kit di strumenti per l'IA e intendiamo ampliarlo nel tempo per includere ulteriori casi di integrazione Stripe e monitorare l'evoluzione delle capacità dei modelli. Accogliamo con piacere feedback, collaborazioni e suggerimenti per benchmark futuri.
Ringraziamo Anthropic per la collaborazione sulle valutazioni per agenti e Vercel per i progetti open source che hanno supportato due delle nostre valutazioni.